AI는 우리가 Big Ball of Mud로 향하는 속도를 높인다 – 하나의 가설
시작은 대개 사소한 subscribe() 하나다
섹션 제목: “시작은 대개 사소한 subscribe() 하나다”지난 10년간 컨설턴트로 일하면서 여러 Angular 애플리케이션을 살펴봤습니다. 그 과정에서 반복해서 본 장면이 있습니다. 조건문, 상태 변경, 알림, 라우팅, 때로는 비즈니스 로직까지 한데 들어 있는 긴 subscribe() 블록입니다.
처음부터 구독 콜백 안에 작은 상태 관리 시스템을 만들려고 한 사람은 거의 없었을 것입니다. 출발점은 아마 이런 단순한 코드였을 겁니다.
loadItem(id: string): void { this.api.loadItem(id).subscribe(item => { this.item = item; });}응답을 받아 속성에 대입합니다. 끝입니다. 이것 자체가 잘못된 코드는 아닙니다. subscribe()가 곧 안티패턴인 것도 아니고 Angular에서 명령형 코드가 금지된 것도 아닙니다.
그런데 3주 후에는 특정 응답에 대한 경고가 필요해집니다. 얼마 뒤에는 화면 이동 조건이 추가됩니다. 다른 컴포넌트에서도 데이터를 써야 하니 캐시까지 채웁니다. 그러다 보면 코드는 다음과 비슷한 모습이 됩니다.
loadItem(id: string): void { this.api.loadItem(id).subscribe(item => { this.item = item; if (item.warning) this.notifications.warn(item.warning); if (item.status === 'archived') this.router.navigate(['/archive']); this.cache.set(id, item); });}이 짧은 예시가 곧바로 Big Ball of Mud를 뜻하지는 않습니다. 다만 변화의 방향을 보여 줍니다. 원래는 값을 전달하는 역할만 하던 구독 콜백이 점점 관련 없는 여러 책임을 떠안습니다. 다음 요구사항은 더 이상 명확한 설계 지점에 도착하지 않습니다. 이미 무엇이든 처리하는 듯한 메서드에 쌓입니다.

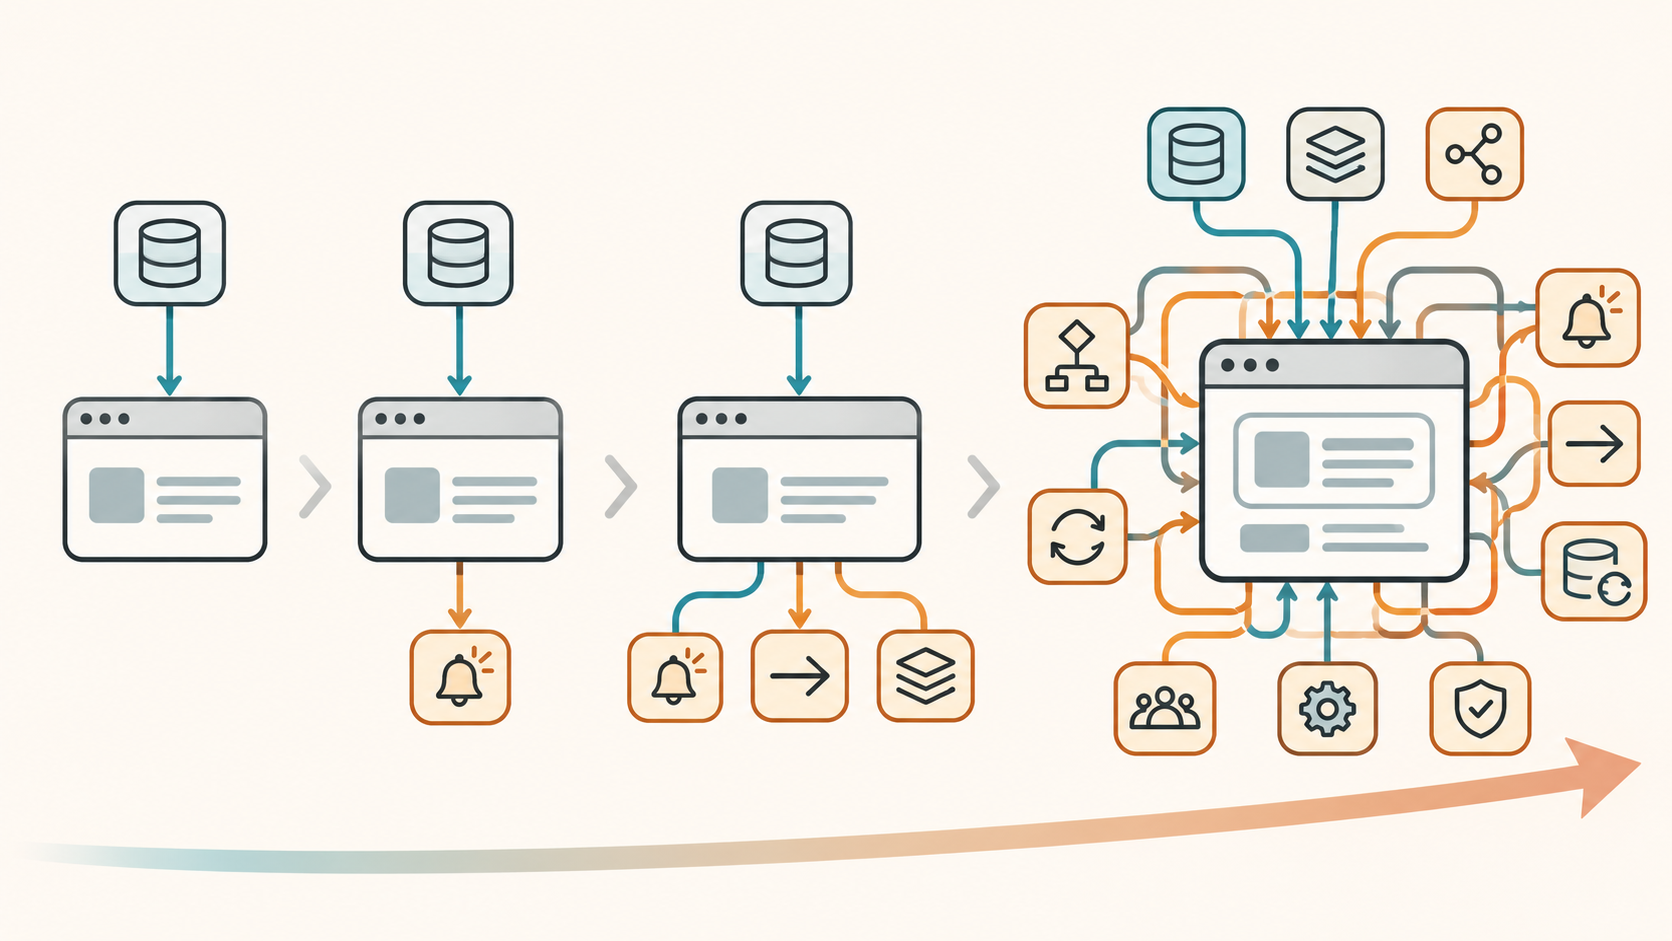
제 추측은 코딩 에이전트가 기능을 더 빨리 구현하게 할 뿐 아니라, 구조적으로 잘못된 결정도 더 빨리 반복하게 만들 수 있다는 것입니다.
그로 인해 아키텍처 경계가 점차 약해진다면, 다음 AI 기반 변경 작업은 오히려 더 많은 노력이 필요할 수도 있습니다. 이 글에서 살펴보려는 것은 아직 직접 검증되지 않은 이 피드백 가능성입니다.
구체적인 오류는 훨씬 일찍 나타날 수 있다
섹션 제목: “구체적인 오류는 훨씬 일찍 나타날 수 있다”컴포넌트가 라우트 파라미터에 따라 데이터를 불러온다고 가정해 보겠습니다. 사용자가 A에서 B로 빠르게 이동하면 서로 독립적인 HTTP 요청 두 개가 발생합니다. B의 응답이 먼저 도착해 올바른 데이터가 표시됩니다. 하지만 뒤늦게 도착한 A의 응답이 this.item을 덮어쓰면 화면에는 오래된 데이터가 보입니다.
Angular가 명령형 문법을 허용하지 않아서 생긴 문제가 아닙니다. 비동기 작업을 적절히 조정하지 않았기 때문입니다. switchMap을 사용하면 B로 전환할 때 이전 내부 구독을 해제합니다. HttpClient Observable을 직접 구독한 경우에는 아직 진행 중인 요청도 중단됩니다. 그러려면 변경되는 ID가 같은 데이터 흐름을 거쳐야 합니다. 독립적으로 loadItem()을 두 번 호출한다고 자동으로 조정되지는 않습니다. 클라이언트에서 요청을 중단해도 서버가 이미 실행한 작업이 취소되지는 않습니다. 표시 상태에는 상황에 따라 AsyncPipe, toSignal(), 명확하게 분리된 Read Model 등을 사용할 수 있습니다.
변경 감지(Change Detection)에서도 구분이 필요합니다. 구독 안에서 일반 속성에 값을 대입하는 것만으로는 Angular에 변경을 알리지 않습니다. 그래도 뷰가 갱신되는지는 다른 계기와 변경 감지 전략에 달려 있습니다. AsyncPipe는 markForCheck()를 호출하며, 템플릿에서 읽는 Signal을 갱신해도 변경 알림이 전달됩니다. 이는 zoneless Angular에서도 중요합니다. Angular는 파생 상태에 computed()를 권장하며, 단순한 상태 전파를 위해 effect()를 사용하지 말라고 안내합니다.
명령형 구문이 문제의 본질은 아닙니다. 반응형 의존성을 명시하는 대신 수동 동기화 규칙을 계속 늘려 놓고도 장기적인 비용이 없다고 가정하는 것이 위험합니다.
예외가 어느새 모범 사례가 된다
섹션 제목: “예외가 어느새 모범 사례가 된다”워크어라운드 하나는 저장소 안에 홀로 남아 있지 않습니다. 다른 개발자가 읽고, 복사하고, 확장합니다. 새로 합류한 개발자가 이를 참고하고, 코딩 에이전트도 기존 코드를 근거로 삼을 수 있습니다. 어제는 설명이 필요했던 예외가 내일은 ‘우리 프로젝트에서 원래 하던 방식’이 됩니다. 아키텍처 경계가 암묵적이라면 저장소 자체가 설계 의도에 대해 서로 모순된 답을 내놓게 됩니다.
여기서 떠오르는 것이 Broken Windows, 즉 깨진 유리창 효과입니다. 비유만으로는 충분하지 않습니다. 그러나 소프트웨어 엔지니어링에서도 관련 실험이 있습니다. Levén, Broman, Besker, Torkar는 2024년 기존 기술 부채가 인간 개발자의 후속 구현에 어떤 영향을 미치는지 연구했습니다. 29명이 제출한 51개 결과를 분석했으며, 기술 부채가 더 많은 Java 시스템에서 중복 코드, 부적절한 이름, 정적 분석 문제가 더 많이 나타났습니다.
이는 실험이 다룬 조건에서 그 효과를 뒷받침합니다. 모든 시스템이 반드시 악순환에 빠진다는 뜻도, 코딩 에이전트가 동일한 메커니즘을 확대한다는 뜻도 아닙니다. 이 경계선을 지키는 것이 중요합니다.
에이전트는 우리가 의도한 아키텍처를 자동으로 따르지 않는다
섹션 제목: “에이전트는 우리가 의도한 아키텍처를 자동으로 따르지 않는다”제 작업에서도 성능이 뛰어난 코딩 에이전트가 익숙한 구현 패턴으로 돌아가는 모습을 가끔 봅니다. 컴포넌트 안의 비즈니스 로직, 명령형 상태 동기화, Capability 경계를 넘어 내부 구현을 직접 가져오는 import 같은 것들입니다. 아키텍처 문서와 에이전트 스킬이 있고 Angular 관련 도구를 사용할 수 있어도 발생합니다.
그렇다고 특정 실행이 왜 그런 결정을 내렸는지 단정할 수는 없습니다. 학습된 패턴, 저장소의 기존 코드, 작업 지시, 도구, 성공 기준이 함께 작용합니다. 모델이 학습 데이터에서 가장 흔한 방식을 단순히 다수결로 선택한다고 설명하는 것도 지나치게 단순합니다.
다만 더 좁은 명제는 이미 연구됐습니다. Yu 등은 2026년 SWE-Shield 프리프린트에서 여섯 저장소의 Issue 495개와 검증된 설계 제약 조건 1,787개를 분석했습니다. 기능적으로 해결된 Issue 가운데 모든 설계 제약 조건을 충족한 비율은 절반 미만이었습니다. 작업별 설계 지침을 추가하면 위반을 줄일 수 있었지만 완전히 없애지는 못했습니다. 설계 적합성은 주로 LLM 검증기로 평가하고 일부 표본을 사람의 판단과 비교했습니다. 완전한 아키텍처 감사는 아닙니다.
기능적으로 올바르다는 사실만으로 아키텍처까지 적절하다고 말할 수 없다는 뜻입니다. 이 부분은 실증 근거가 있습니다. 그러나 에이전트가 유독 Angular의 나쁜 패턴을 복제하는지는 아직 제 경험과 열린 연구 질문의 영역입니다.
Big Ball of Mud의 핵심은 경계의 소실이다
섹션 제목: “Big Ball of Mud의 핵심은 경계의 소실이다”제가 말하는 Big Ball of Mud는 단순히 코드가 많거나 컴포넌트가 길다는 뜻이 아닙니다. 더 중요한 것은 믿을 수 있는 경계가 사라진다는 점입니다. 소유권(Ownership)이 불분명해지고, 비즈니스 규칙이 여러 곳에 흩어지며, 모듈이 서로의 내부 구현을 자유롭게 참조합니다. 하나의 모듈은 더 이상 국소적인 작업 공간이 아니라 예측하기 어려운 의존성 네트워크의 일부가 됩니다.
Foote와 Yoder는 1990년대에 국소적으로는 합리적이고 단기적으로 유용한 결정들이 어떻게 이런 시스템을 만들어 내는지 설명했습니다. 그렇다고 시스템이 곧바로 작동을 멈추는 것은 아닙니다. 오랫동안 충분히 쓸 만하게 운영될 수도 있습니다.
Bochicchio, Sas, Gilardi, Arcelli Fontana(2025)의 실증 연구에서는 두 파일 모두 또는 하나에 아키텍처 스멜이 있는 파일 쌍이 스멜이 없는 쌍보다 동시 변경(Co-change) 빈도의 중앙값이 높았습니다. 이는 변경 영향이 더 넓을 수 있다는 단서이며, 일반적인 인과관계나 필연적인 품질 악화를 입증하지는 않습니다.
아직 열린 질문: 다음 에이전트 작업은 얼마가 들까?
섹션 제목: “아직 열린 질문: 다음 에이전트 작업은 얼마가 들까?”여기까지는 오래된 소프트웨어 엔지니어링 문제처럼 들릴 수도 있습니다. 이제 달라지는 변수는 처리량(Throughput)입니다. 코딩 에이전트는 짧은 시간 안에 시스템의 여러 부분을 수정할 수 있습니다. 검증이 그 속도를 따라가지 못하면 개별적인 예외도 더 빠르게 퍼질 수 있습니다. 반대로 기술 부채를 더 빠르게 상환할 수도 있습니다. 방향은 정해져 있지 않습니다.
제 경제적 가설은 다음 작업에 초점을 둡니다. 소유권, 계약, 의존성 방향이 명확하면 이상적으로는 에이전트가 제한된 작업 범위만 이해하면 됩니다. 반면 강하게 결합된 시스템에서는 더 많은 파일, 암묵적인 부작용, 서로 다른 규칙이 모두 관련 있어 보일 수 있습니다. 에이전트는 이들을 찾고, 이해하고, 관련성이 없음을 확인해야 할 수 있습니다.
그 결과 컨텍스트 수집, 도구 호출, 테스트 범위, 수정 반복이 늘어나고 검증된 변경 한 건의 비용이 높아질 가능성이 있습니다. 물론 모든 실행에서 그런 것은 아니며, 더 강력한 모델이 일부 비용을 상쇄할 수도 있습니다.
Bai 등(2026)은 프리프린트에서 여덟 모델이 OpenHands로 SWE-bench Verified 작업을 수행하는 과정을 연구했습니다. 입력 토큰은 상당한 비용 비중을 차지했고, 같은 작업도 실행에 따라 토큰 소비량이 크게 달랐으며, 더 많은 토큰이 자동으로 더 높은 성공률로 이어지지는 않았습니다. 그러나 나쁜 아키텍처가 그 소비량을 유발하는지는 확인하지 않았습니다. 제 인과 사슬의 마지막 고리는 여전히 가설입니다.
어느 연결고리가 연구됐고, 무엇이 아직 가설인가?
섹션 제목: “어느 연결고리가 연구됐고, 무엇이 아직 가설인가?”-
조정되지 않은 비동기 요청이 오래된 결과로 UI 상태를 덮어쓸 수 있습니다. 기술적으로 재현 가능하며 Angular·RxJS에 해당 메커니즘이 문서화되어 있습니다.
-
기존 기술 부채가 후속 기술 부채를 유도할 수 있습니다. 제한된 Java 환경에서 인간 개발자를 대상으로 한 실험적 근거가 있습니다(Levén 등, 2024).
-
코딩 에이전트가 기능적으로 올바른 패치를 생성하면서 설계 제약 조건을 위반할 수 있습니다. 실증적으로 연구됐습니다(Yu 등, 2026).
-
아키텍처 스멜은 더 높은 동시 변경 빈도와 관련이 있을 수 있습니다. 실증적 연관성이며 보편적인 인과관계의 증명은 아닙니다(Bochicchio 등, 2025).
-
에이전트 토큰 소비량은 크게 변동하며 입력 토큰의 비중이 큽니다. 실증적으로 연구됐습니다(Bai 등, 2026).
-
AI 처리량이 높아지면 아키텍처 침식이 빨라지고 장기적인 토큰 및 검증 비용도 높아질 수 있습니다. 전체 인과관계는 아직 검증되지 않은 가설입니다.
나의 가설 – 어디까지나 가설이다
섹션 제목: “나의 가설 – 어디까지나 가설이다”아키텍처 경계가 약한 시스템에서 코딩 에이전트가 변경을 만들어 내는 속도가 빨라질수록 일부 구조적 실수가 더 빠르게 확산될 수 있습니다. 그 실수로 인해 다음 변경에 필요한 분석과 검증 범위가 커진다면, 이후 에이전트 작업의 비용도 높아질 수 있습니다.
일종의 피드백 루프입니다. 빠른 코드 생산이 시스템 구조를 바꾸고, 바뀐 구조가 다음 코드 생산에 필요한 작업량을 다시 바꿉니다.
여러 개별 연구를 연결했다고 전체 인과관계가 증명되는 것은 아닙니다. 반대 가설도 충분히 그럴듯합니다. 더 나은 에이전트는 Big Ball of Mud를 더 싸게 탐색하고, 새 문제가 생기는 속도보다 더 빠르게 구조적 결함을 찾아 리팩터링할 수도 있습니다. 어떤 조건에서 어느 쪽이 우세할지는 아직 모릅니다.
25유로 구독에 관한 농담을 한 이유
섹션 제목: “25유로 구독에 관한 농담을 한 이유”한번은 Guardrail에 대해 토론하던 중 상대방이 충분히 뛰어난 AI라면 그런 규칙을 스스로 결정할 수 있다고 주장했습니다. 조금 전에는 사용 가능량이 너무 빨리 소진된다고 불평하던 사람이었습니다. 저는 건조하게 한마디 했습니다. “그래서 내 25유로 구독은 충분한데, 당신 것은 그렇지 않은 거군요.”
물론 농담이지 벤치마크는 아닙니다. 모델, 사용 한도, 작업, 과금 방식이 서로 다르기 때문에 방법론적으로 비교할 가치가 없습니다. 저도 두세 개의 에이전트 작업을 병렬로 돌리는 경우가 많지만, 평소에는 대체로 제 사용량 안에서 작업합니다.
제가 의도적으로 하는 것은 Capability 단위로 작업을 나누고, Feature마다 아키텍처를 다시 결정하지 않으며, 좋은 의도보다 실행 가능한 검증 규칙을 우선하는 것입니다. 이런 방식이 실제로 토큰을 절약하는지 엄밀하게 측정한 적은 없습니다. 중요한 지표는 첫 실행의 사용량보다 ‘검증되고 수용 가능한 변경 한 건의 총비용’입니다. 특히 많은 후속 Feature까지 생각한다면 더욱 그렇습니다.
Guardrail: 더 긴 지침보다 검증 가능한 경계
섹션 제목: “Guardrail: 더 긴 지침보다 검증 가능한 경계”해결책이 에이전트 지침 파일을 무한정 길게 쓰는 것일 수는 없습니다. Gloaguen 등(2026)은 프리프린트에서 조사한 환경에서 저장소 컨텍스트 파일이 작업 성공률을 일반적으로 높인다는 결과를 얻지 못했으며, 추론 비용은 평균 20% 넘게 증가했습니다. 에이전트가 지침을 따르더라도 추가 요구사항이 작업량을 늘릴 수 있다는 뜻입니다.
시스템이 검증할 수 있는 규칙을 저는 문장에만 맡기고 싶지 않습니다. Capability 사이의 금지된 import는 아키텍처 검사가 잡아야 합니다. 도메인 불변 조건은 테스트로 검증해야 합니다. 프로젝트에 맞춘 경계는 짧고 찾기 쉬운 설명과 소수의 대표적인 예시에 남기면 됩니다. 자동 검사로 판별하기 어려운 곳에는 집중적인 아키텍처 리뷰가 필요합니다.
Guardrail은 모든 개별 결정을 세세하게 통제하는 장치가 아닙니다. 구조적으로 비용이 큰 결정을 의도적으로 바꾸기 전까지 안정적으로 유지하는 장치입니다.
이 가설을 어떻게 검증할 수 있을까?
섹션 제목: “이 가설을 어떻게 검증할 수 있을까?”잘 관리된 모듈형 시스템과 테스트조차 없는 방치된 저장소를 비교하는 것은 적절하지 않습니다. 너무 많은 변수가 동시에 달라집니다.
더 나은 출발점은 기능적으로 동일한 기준 시스템에서 아키텍처 경계를 통제된 방식으로 다르게 만드는 것입니다. 동일한 에이전트가 여러 반복 실행에서 같은 순서로, 예를 들어 15개 Feature를 구현합니다. 한 그룹은 기계적으로 경계를 강제하고, 다른 그룹은 문서로만 안내하며, 세 번째 그룹에는 더 많은 구조적 자유를 줍니다. 모델, 도구, 테스트, 인수 기준은 가능한 한 비교할 수 있도록 유지합니다.
이때 설계 제약 위반, 변경 반경, Co-change, 탐색·검증 단계, 수정 반복, 토큰 소비량, 최종 수용 변경당 총비용을 측정해야 합니다. 특히 첫 번째 결과보다 작업이 누적될수록 지표가 어떻게 변하는지를 보고 싶습니다.
차이가 발견되더라도 그것은 인과관계의 확정이 아니라 유용한 증거입니다. 반복 실험과 통제, 그리고 아키텍처 품질의 명확한 조작적 정의가 추가로 필요합니다.
결론: 첫 번째 변경만 측정해서는 안 된다
섹션 제목: “결론: 첫 번째 변경만 측정해서는 안 된다”AI가 더 많은 코드를 생성할 수 있다는 사실이 좋은 아키텍처의 가치를 없애지는 않습니다. 오히려 경계가 어떻게 침식되는지 더 면밀히 살펴봐야 한다는 뜻일 수 있습니다.
저는 코딩 에이전트가 반드시 나쁜 아키텍처를 만든다고 생각하지 않습니다. 구조적 문제를 찾아 수정할 수도 있습니다. 그러나 기능적 정확성이 설계 적합성을 대신할 수 있는 확실한 기준이 아니고 아키텍처와 에이전트 비용 사이의 직접적인 관계도 아직 확인되지 않았다면, 유용한 경계를 성급하게 포기할 이유는 없습니다.
중요한 질문은 이제 “오늘의 Feature를 얼마나 빨리 구현하는가?”만이 아닙니다.
“오늘의 구현이 다음 백 번의 변경 비용에 어떤 영향을 주는가?”입니다.
어쩌면 AI는 개발 속도만 높이는 것이 아닙니다. 적절한 아키텍처 관리가 없다면 Big Ball of Mud로 향하는 속도도 높일 수 있습니다.
연구 및 참고 자료
섹션 제목: “연구 및 참고 자료”- William Levén, Hampus Broman, Terese Besker, Richard Torkar (2024). The broken windows theory applies to technical debt. Empirical Software Engineering 29, 73.
- Kai Yu et al. (2026). Does Pass Rate Tell the Whole Story? Evaluating Design Constraint Compliance in LLM-based Issue Resolution. SWE-Shield; 프리프린트, arXiv:2604.05955v1.
- Matteo Bochicchio, Darius Sas, Alessandro Gilardi, Francesca Arcelli Fontana (2025). An empirical study on architectural smells through a pipeline for continuous technical debt assessment. Information and Software Technology 185, 107783.
- Thibaud Gloaguen et al. (2026). Evaluating AGENTS.md: Are Repository-Level Context Files Helpful for Coding Agents?. 프리프린트, arXiv:2602.11988v3.
- Longju Bai et al. (2026). How Do AI Agents Spend Your Money? Analyzing and Predicting Token Consumption in Agentic Coding Tasks. 프리프린트, arXiv:2604.22750v3.
- Brian Foote, Joseph Yoder (1997/1999). Big Ball of Mud. PLoP ’97, WUCS-97-34; Web 1999; Pattern Languages of Program Design 4, 2000.
- Angular: HTTP Observables / cancellation, Zoneless, Signals / computed, Effects, RxJS interop.
- RxJS: switchMap.