KI beschleunigt unseren Weg in den Big Ball of Mud – eine Hypothese
Es beginnt oft mit einem harmlosen subscribe()
Abschnitt betitelt „Es beginnt oft mit einem harmlosen subscribe()“In den vergangenen zehn Jahren habe ich als Consultant zahlreiche Angular-Anwendungen kennengelernt. Ein Muster ist mir dabei immer wieder begegnet: Komponenten mit langen subscribe()-Blöcken, in denen Zustandsänderungen, Bedingungen, Benachrichtigungen, Routing und fachliche Abläufe ineinanderliefen.
Ich glaube nicht, dass jemand diese Methoden absichtlich als kleine State-Management-Systeme entworfen hat. Oft begann es vermutlich mit einer völlig nachvollziehbaren Entscheidung:
loadItem(id: string): void { this.api.loadItem(id).subscribe(item => { this.item = item; });}Das Ergebnis wird einer Property zugewiesen. Fertig. Daran ist zunächst nichts grundsätzlich falsch. Ein subscribe() ist kein Anti-Pattern an sich, und imperativer Code ist in Angular keineswegs verboten.
Drei Wochen später soll beim Laden eine Warnung erscheinen. Dann wird nach bestimmten Ergebnissen navigiert. Später braucht eine andere Komponente dieselben Daten, weshalb die Methode einen Cache befüllt. Irgendwann sieht sie etwa so aus:
loadItem(id: string): void { this.api.loadItem(id).subscribe(item => { this.item = item; if (item.warning) this.notifications.warn(item.warning); if (item.status === 'archived') this.router.navigate(['/archive']); this.cache.set(id, item); });}Diese kleine Illustration ist noch kein Big Ball of Mud. Sie zeigt aber eine gefährliche Richtung: Eine Subscription, die zunächst einen Wert übergab, übernimmt zunehmend die Orchestrierung unterschiedlicher Verantwortlichkeiten. Die nächste Anforderung findet keinen eindeutigen Ort mehr vor – sondern eine Methode, die bereits alles Mögliche tut.

Grafik in Originalgröße öffnen
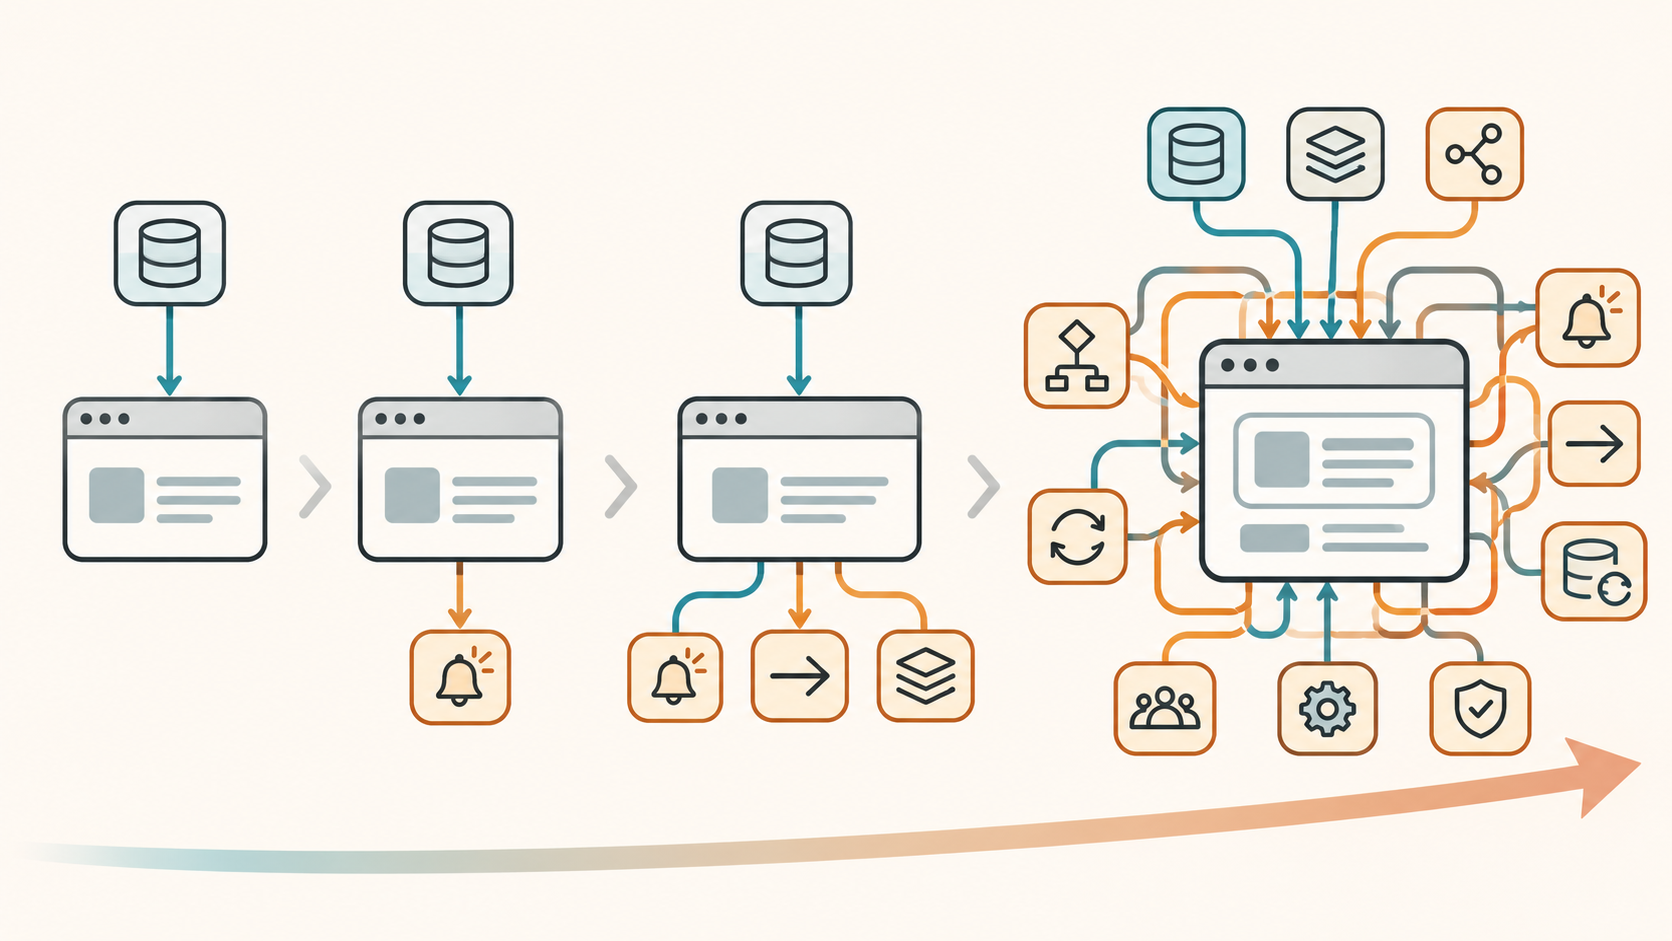
Meine Vermutung ist, dass wir mit Coding Agents nicht nur schneller neue Funktionen implementieren, sondern möglicherweise auch strukturelle Fehlentscheidungen schneller vervielfältigen.
Wenn dadurch Architekturgrenzen zunehmend aufweichen, könnte ausgerechnet die nächste KI-generierte Änderung aufwendiger werden. Genau diesen möglichen Rückkopplungseffekt möchte ich in diesem Artikel untersuchen.
Ein konkreter Fehler entsteht schon vorher
Abschnitt betitelt „Ein konkreter Fehler entsteht schon vorher“Angenommen, eine Komponente lädt anhand eines Routenparameters einen Datensatz. Der Benutzer wechselt schnell von A nach B. Für beide IDs läuft ein unabhängiger HTTP-Request. Antwort B trifft zuerst ein und zeigt den richtigen Datensatz an. Dann kommt die ältere Antwort A zurück und überschreibt this.item. Die Oberfläche zeigt veraltete Daten.
Das Problem ist nicht, dass Angular imperative Syntax verbietet. Das Problem ist unkoordinierte Asynchronität. Ein reaktiver Datenfluss mit switchMap beendet beim Wechsel auf B die vorherige innere Subscription; bei einem direkt abonnierten HttpClient-Observable wird dadurch ein noch laufender Request abgebrochen. Dafür müssen die wechselnden IDs denselben Datenfluss durchlaufen. Zwei unabhängige Aufrufe von loadItem() koordinieren sich nicht von selbst. Ein Abbruch beim Client nimmt außerdem keine bereits ausgeführte Serveraktion zurück. Für Anzeigezustand bieten sich je nach Situation AsyncPipe, toSignal() oder andere klar geregelte Read-Modelle an.
Ähnlich vorsichtig muss man bei Change Detection argumentieren: Eine Zuweisung an eine gewöhnliche Property in einer Subscription benachrichtigt Angular nicht selbst über die Änderung. Ob die View trotzdem aktualisiert wird, hängt von weiteren Auslösern und der Change-Detection-Strategie ab. AsyncPipe ruft markForCheck() auf; die Aktualisierung eines im Template gelesenen Signals liefert ebenfalls einen solchen Hinweis. Das ist auch unter zoneless Angular relevant. Für abgeleiteten Zustand empfiehlt Angular computed() und warnt vor effect() zur bloßen State-Propagation.
Nicht jede imperative Anweisung ist falsch. Falsch wäre vielmehr die Schlussfolgerung, dass man ein reaktives Modell dauerhaft durch immer neue lokale Synchronisationsregeln ersetzen kann, ohne sich damit zusätzliche Verpflichtungen einzukaufen.
Aus Ausnahmen werden Vorbilder
Abschnitt betitelt „Aus Ausnahmen werden Vorbilder“Ein Workaround steht selten isoliert im Repository. Er wird gelesen, kopiert und erweitert. Ein neuer Entwickler orientiert sich daran, ein Agent ebenfalls. Was gestern eine begründete Ausnahme war, kann morgen als übliche Implementierung gelten. Wenn die eigentliche Grenze nicht explizit ist, liefern vorhandene Beispiele plötzlich widersprüchliche Antworten auf dieselbe Architekturfrage.
Dieser Mechanismus erinnert an Broken Windows. Die Metapher allein wäre eine schwache Begründung. Es gibt aber Forschung dazu: Levén, Broman, Besker und Torkar untersuchten 2024 in einem kontrollierten Experiment an kleinen Java-Systemen, wie vorhandene technische Schuld die Arbeit menschlicher Entwickler beeinflusst. In 51 Lösungen von 29 Teilnehmern zeigte sich unter anderem mehr Duplikation, schlechtere Benennung und zusätzliche statisch erkannte Probleme in stärker belasteten Systemen.
Das stützt den Effekt unter den untersuchten Bedingungen. Es beweist weder eine zwangsläufige Abwärtsspirale noch, dass Coding Agents denselben Mechanismus verstärken. Genau diese Grenze ist wichtig.
Der Agent übernimmt nicht automatisch die beabsichtigte Architektur
Abschnitt betitelt „Der Agent übernimmt nicht automatisch die beabsichtigte Architektur“In meiner eigenen Arbeit beobachte ich, dass selbst sehr leistungsfähige Coding Agents gelegentlich in vertraute Muster zurückfallen: Business-Logik in Components, imperative State-Synchronisierung, direkte Imports über Capability-Grenzen hinweg. Das geschieht auch dann, wenn Architekturregeln dokumentiert, Skills vorhanden und Angular-Werkzeuge zugänglich sind.
Warum genau ein einzelner Agent in einem konkreten Run so entscheidet, lässt sich daraus nicht ableiten. Gelernte Muster, der vorhandene Repository-Code, die Aufgabenbeschreibung, verfügbare Tools und die Erfolgskriterien wirken zusammen. Ich würde insbesondere nicht behaupten, dass das Modell schlicht eine Mehrheitsabstimmung seiner Trainingsbeispiele durchführt.
Empirisch untersucht ist aber eine andere, engere Aussage: Yu et al. analysierten 2026 im Preprint zu SWE-Shield 495 Issues aus sechs Repositories mit 1.787 validierten Design-Constraints. Weniger als die Hälfte der funktional gelösten Issues erfüllte alle untersuchten Designvorgaben. Zusätzliche Designhinweise reduzierten Verstöße, beseitigten sie jedoch nicht vollständig. Die Designkonformität wurde überwiegend mit einem LLM-Verifier bewertet und stichprobenartig mit menschlichen Urteilen verglichen. Das ist kein vollständiges Architekturaudit.
Funktional korrekt ist also nicht automatisch architektonisch akzeptabel. Dieser Zusammenhang ist untersucht. Ob Angular-typische Workarounds deshalb von Agents bevorzugt vervielfältigt werden, bleibt meine Beobachtung und eine offene Forschungsfrage.
Big Ball of Mud bedeutet verlorene Grenzen
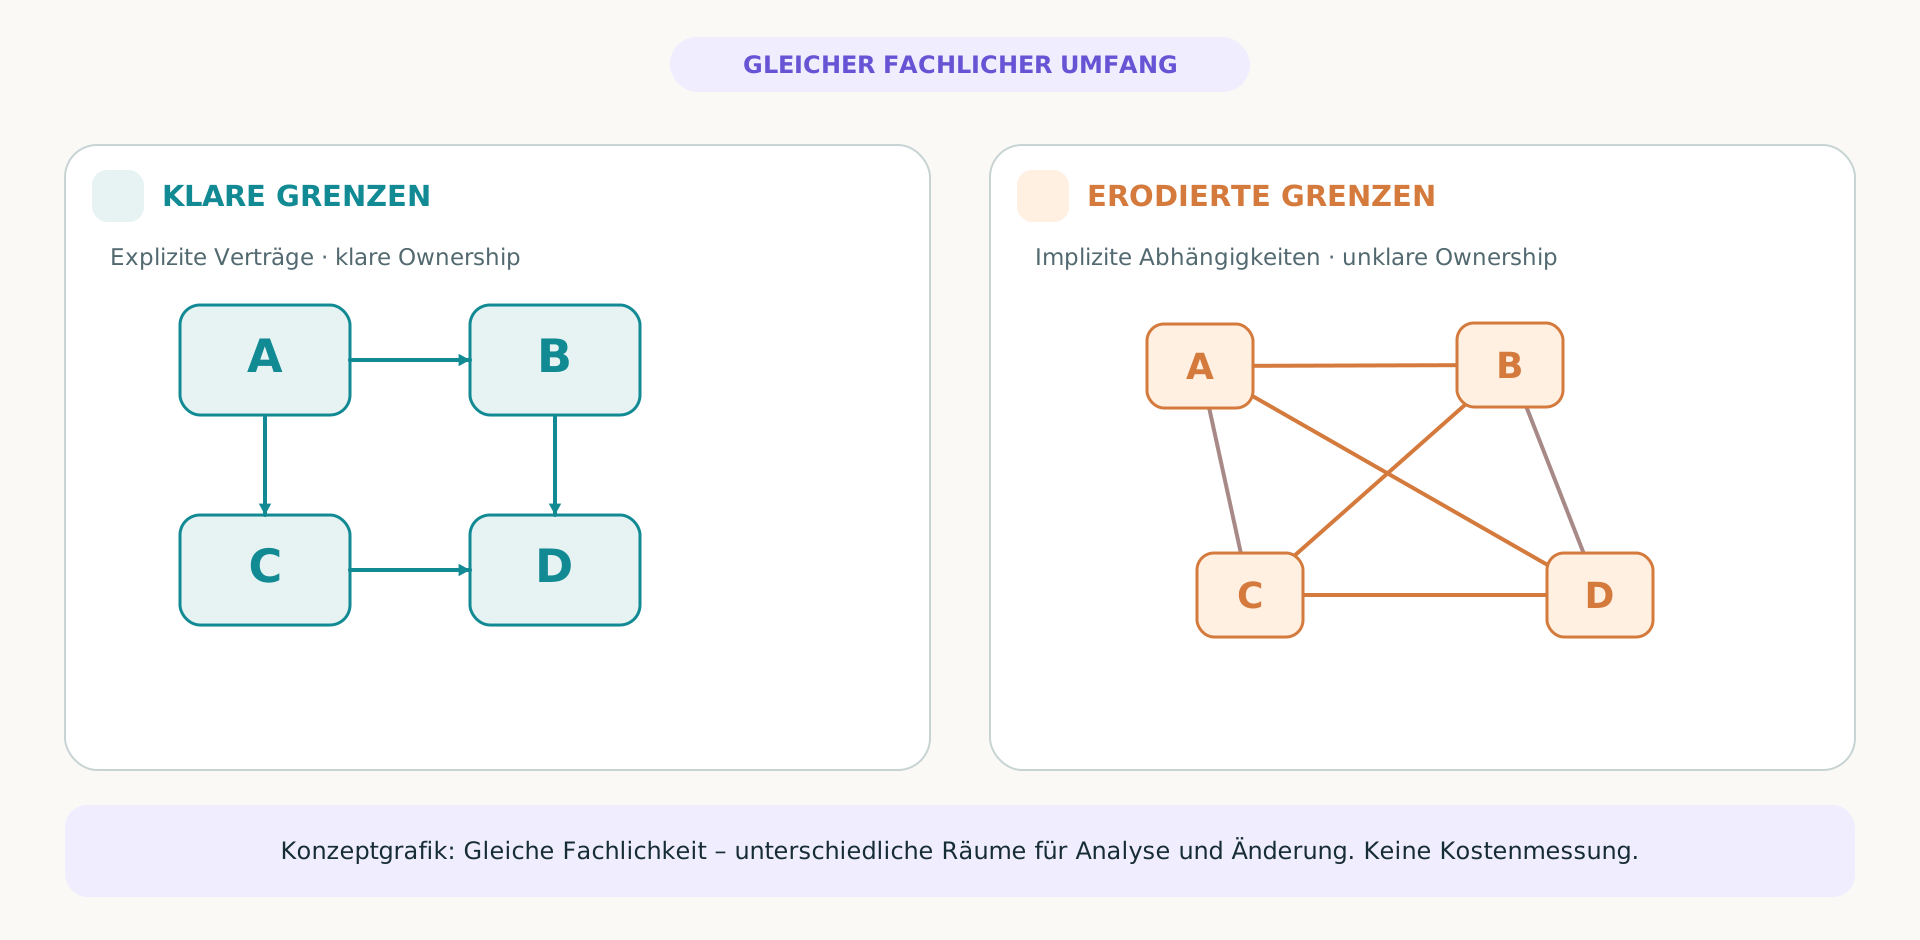
Abschnitt betitelt „Big Ball of Mud bedeutet verlorene Grenzen“Ein Big Ball of Mud ist für mich nicht bloß eine große Codebasis oder eine lange Component. Im Kern gehen verlässliche Grenzen verloren. Ownership ist unklar. Fachliche Regeln haben mehrere Orte. Jeder Bereich kann Interna anderer Bereiche erreichen. Ein Modul ist kein lokaler Arbeitsraum mehr, sondern ein Ausschnitt aus einem schwer vorhersagbaren Netz.
Foote und Yoder beschrieben bereits in den 1990er-Jahren, wie solche Systeme aus lokal verständlichen, kurzfristig nützlichen Entscheidungen entstehen können. Das bedeutet nicht, dass sie sofort funktionsunfähig sind. Im Gegenteil: Sie können über lange Zeit brauchbar bleiben.
Bochicchio, Sas, Gilardi und Arcelli Fontana (2025) fanden in einer empirischen Studie höhere mediane Co-change-Raten bei Dateipaaren, in denen beide oder eine Datei von architektonischen Smells betroffen waren, als bei unbelasteten Paaren. Das ist ein Hinweis auf größere Änderungsauswirkungen, kein allgemeiner Kausalnachweis und kein Gesetz zwangsläufigen Zerfalls.
Grafik in Originalgröße öffnen
Die offene Frage: Was kostet der nächste Agentenauftrag?
Abschnitt betitelt „Die offene Frage: Was kostet der nächste Agentenauftrag?“Die bisherige Argumentation könnte man als alte Software-Engineering-Geschichte abtun. Die neue Variable ist der Durchsatz. Coding Agents können in kurzer Zeit zahlreiche Stellen konsistent verändern. Damit können sie auch lokale Ausnahmen schneller vervielfältigen – sofern die Verifikation nicht mithält. Ebenso können sie technische Schuld schneller abbauen. Die Richtung ist nicht vorgegeben.
Meine wirtschaftliche Vermutung betrifft den nächsten Auftrag: Wenn Ownership, Verträge und Abhängigkeitsrichtungen klar sind, muss ein Agent idealerweise nur einen begrenzten Arbeitsraum verstehen. In einem stark gekoppelten System könnten mehr Dateien, implizite Seiteneffekte und konkurrierende Muster plausibel relevant sein. Mehr davon muss gesucht, verstanden oder ausgeschlossen werden.
Daraus könnten zusätzliche Context Acquisition, weitere Tool-Aufrufe, breitere Tests, Korrekturschleifen und schließlich höhere Kosten pro verifizierter Änderung entstehen. Nicht zwingend bei jedem Run – und möglicherweise kompensiert durch leistungsfähigere Modelle.
Bai et al. (2026) untersuchen im Preprint acht Modelle mit OpenHands auf SWE-bench Verified. Sie zeigen, dass Input-Tokens einen wesentlichen Kostenanteil haben, dass Verbräuche bei derselben Aufgabe stark schwanken können und dass mehr Tokens nicht automatisch höhere Erfolgsraten bedeuten. Die Studie misst jedoch nicht, ob schlechte Architektur diesen Verbrauch verursacht. Das letzte Glied meiner Kette ist bislang eine Hypothese.
Was ist untersucht – und was nicht?
Abschnitt betitelt „Was ist untersucht – und was nicht?“-
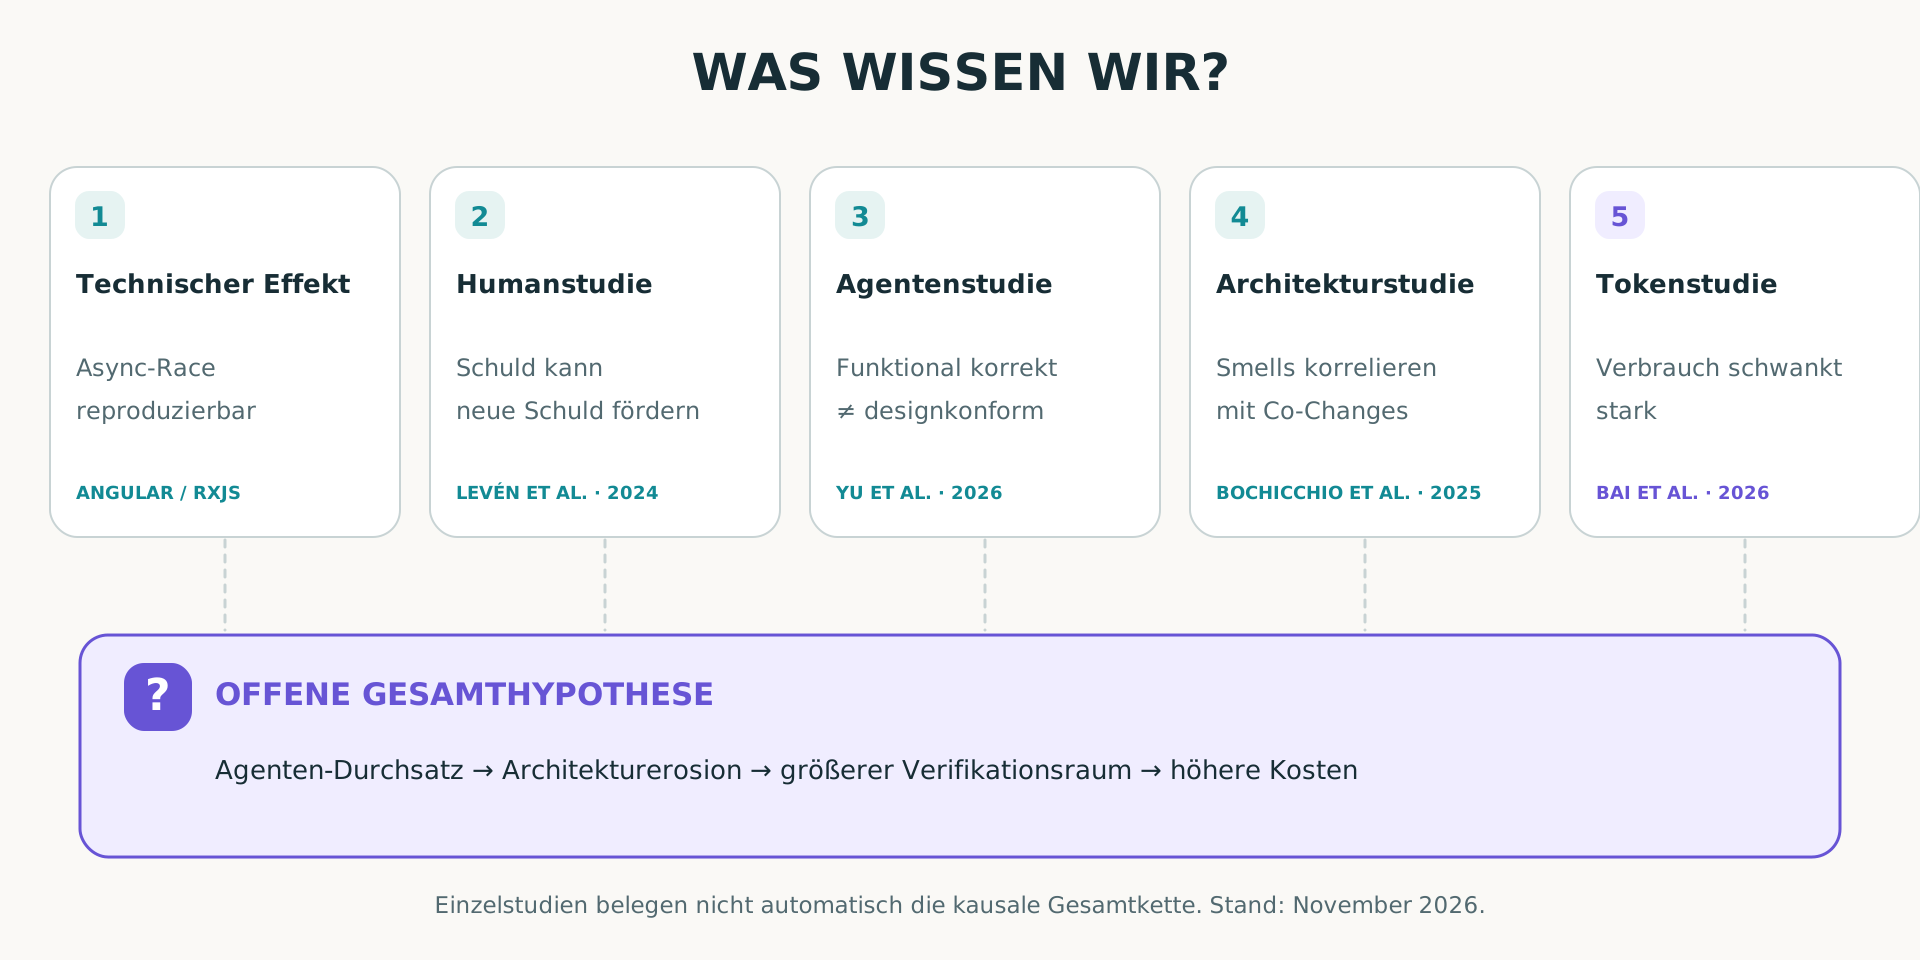
Unkoordinierte asynchrone Requests können veraltete UI-Zustände schreiben. TECHNISCH REPRODUZIERBAR; Angular- und RxJS-Mechanismen sind dokumentiert.
-
Vorhandene technische Schuld kann weitere Schuld begünstigen. EXPERIMENTELL GESTÜTZT für menschliche Entwickler in einem kleinen Java-Setting (Levén et al., 2024).
-
Coding Agents können funktional richtige Patches erzeugen, die Design-Constraints verletzen. EMPIRISCH UNTERSUCHT (Yu et al., 2026).
-
Architektonische Smells können mit höheren Co-change-Raten zusammenhängen. EMPIRISCHE ZUSAMMENHÄNGE; kein universeller Kausalnachweis (Bochicchio et al., 2025).
-
Agentischer Tokenverbrauch variiert stark und wird durch Input-Tokens geprägt. EMPIRISCH UNTERSUCHT (Bai et al., 2026).
-
Höherer KI-Durchsatz könnte Architekturerosion beschleunigen, die ihrerseits langfristig Token- und Verifikationskosten erhöhen könnte. OFFENE GESAMTHYPOTHESE.
Grafik in Originalgröße öffnen
Meine Hypothese – bewusst als Hypothese
Abschnitt betitelt „Meine Hypothese – bewusst als Hypothese“Je schneller Coding Agents in Systemen mit schwachen Architekturgrenzen Änderungen erzeugen, desto schneller könnten sich bestimmte strukturelle Fehlentscheidungen ausbreiten. Wenn dadurch der relevante Analyse- und Verifikationsraum wächst, könnten die Kosten späterer Agentenänderungen ebenfalls steigen.
Es wäre eine Rückkopplung: Schnellere Codeproduktion verändert die Struktur, und die Struktur verändert den Aufwand der nächsten Codeproduktion.
Das ist keine aus den Einzelstudien ableitbare Kausalbehauptung. Auch die Gegenhypothese ist plausibel: Bessere Agents navigieren den Big Ball of Mud günstiger, erkennen Smells und refactoren sie schneller, als neue entstehen. Wir wissen noch nicht, welche Dynamik unter welchen Bedingungen dominiert.
Warum ich mir den Spruch mit dem 25-Euro-Abo erlaubt habe
Abschnitt betitelt „Warum ich mir den Spruch mit dem 25-Euro-Abo erlaubt habe“In einer Diskussion über Guardrails vertrat mein Gegenüber die Ansicht, dass leistungsfähige KI all diese Regeln ohnehin selbst entscheiden könne. Kurz zuvor hatte er sich über schnell verbrauchte Nutzungskontingente beklagt. Meine trockene Antwort war: „Und deshalb reicht mein 25-Euro-Abo aus und deins nicht.“
Das war eine Spitze, kein Benchmark. Unterschiedliche Modelle, Limits, Workloads und Abrechnungsmodelle machen den Vergleich methodisch wertlos. Ich arbeite selbst intensiv mit zwei bis drei parallelen Agentenaufgaben, komme im normalen Alltag aber meist gut mit meinem Kontingent aus.
Was ich bewusst tue: Aufgaben nach Capabilities schneiden, Architekturentscheidungen nicht bei jedem Feature neu verhandeln und automatische Prüfungen statt bloßer Hoffnung einsetzen. Ob ich damit wirklich Tokens spare, habe ich nicht kontrolliert gemessen. Entscheidend wäre ohnehin nicht der Verbrauch des ersten Runs, sondern der Preis pro verifizierter, akzeptabler Änderung – auch nach vielen weiteren Features.
Guardrails: weniger gute Absichten, mehr überprüfbare Grenzen
Abschnitt betitelt „Guardrails: weniger gute Absichten, mehr überprüfbare Grenzen“Die Konsequenz kann nicht lauten, einfach immer längere Agent Files zu schreiben. Gloaguen et al. (2026) fanden im untersuchten Preprint-Setting keine allgemeine Verbesserung der Aufgabenerfolgsrate durch Repository-Kontextdateien; die Inferenzkosten stiegen im Mittel um mehr als 20 Prozent. Zusätzliche Anforderungen können Arbeit erzeugen, selbst wenn Agents ihnen folgen.
Ich möchte deshalb möglichst wenig Prosa dort einsetzen, wo das System selbst eine Regel prüfen kann. Ein Capability-Import über eine verbotene Grenze gehört in eine Architecture Rule. Eine fachliche Invariante in einen Test. Ein projektspezifischer Schnitt in eine kurze, auffindbare Beschreibung und wenige repräsentative Beispiele. Und dort, wo automatisierte Regeln zu grob sind, bleibt ein gezieltes Architekturaudit nötig.
Guardrails sollen nicht jede lokale Entscheidung vorgeben. Sie sollen die strukturell teuren Entscheidungen stabil halten – bis wir sie bewusst ändern.
Wie ließe sich die Hypothese prüfen?
Abschnitt betitelt „Wie ließe sich die Hypothese prüfen?“Interessant wäre kein Vergleich zwischen einem ideal gepflegten System mit vollständiger CI und einem verwahrlosten Repository ohne Tests. Dann wäre unklar, was wir eigentlich gemessen haben.
Besser wäre eine identische fachliche Ausgangsbasis mit kontrolliert variierten Architekturgrenzen. Derselbe Agent bearbeitet in mehreren wiederholten Durchläufen dieselbe Folge von beispielsweise 15 Features. Eine Variante erzwingt Grenzen mechanisch, eine dokumentiert sie nur, eine lässt mehr strukturelle Freiheit. Tooling, Modell, Tests und Abnahmekriterien bleiben möglichst vergleichbar.
Gemessen werden Architekturverletzungen, Change Radius, Co-Changes, Analyse- und Verifikationsschritte, Korrekturschleifen, Tokenverbrauch und die Gesamtkosten pro akzeptierter Änderung. Vor allem interessiert mich die Entwicklung über die Folge der Aufgaben – nicht nur die erste Lösung.
Wenn sich die Kurven unterscheiden, hätten wir einen ersten Hinweis. Für einen belastbaren Kausalnachweis wären Replikationen, Kontrollen und eine klare Operationalisierung von Architekturqualität nötig.
Fazit: Wir sollten nicht nur die erste Änderung messen
Abschnitt betitelt „Fazit: Wir sollten nicht nur die erste Änderung messen“Dass KI mehr Code erzeugen kann, macht gute Architektur nicht automatisch überflüssig. Es kann sogar bedeuten, dass wir ihre Erosion schneller beobachten müssen.
Ich glaube nicht, dass Coding Agents zwangsläufig schlechtere Architektur bauen. Sie können strukturelle Fehler ebenso gut entdecken und korrigieren. Aber solange funktionale Korrektheit kein verlässlicher Ersatz für Designkonformität ist und der direkte Zusammenhang zwischen Architektur und Agentenkosten nicht geklärt wurde, sehe ich keinen guten Grund, sinnvolle Grenzen vorschnell aufzugeben.
Die spannende Frage lautet nicht nur: Wie schnell implementiert ein Agent das Feature von heute?
Sie lautet: Wie beeinflusst diese Implementierung die Kosten der nächsten hundert Änderungen?
Denn vielleicht beschleunigen wir mit KI nicht nur unsere Entwicklung. Vielleicht beschleunigen wir – ohne entsprechende Architekturarbeit – auch unseren Weg in den Big Ball of Mud.
Forschung und weiterführende Quellen
Abschnitt betitelt „Forschung und weiterführende Quellen“- William Levén, Hampus Broman, Terese Besker, Richard Torkar (2024). The broken windows theory applies to technical debt. Empirical Software Engineering 29, 73.
- Kai Yu et al. (2026). Does Pass Rate Tell the Whole Story? Evaluating Design Constraint Compliance in LLM-based Issue Resolution. SWE-Shield; Preprint, arXiv:2604.05955v1.
- Matteo Bochicchio, Darius Sas, Alessandro Gilardi, Francesca Arcelli Fontana (2025). An empirical study on architectural smells through a pipeline for continuous technical debt assessment. Information and Software Technology 185, 107783.
- Thibaud Gloaguen et al. (2026). Evaluating AGENTS.md: Are Repository-Level Context Files Helpful for Coding Agents?. Preprint, arXiv:2602.11988v3.
- Longju Bai et al. (2026). How Do AI Agents Spend Your Money? Analyzing and Predicting Token Consumption in Agentic Coding Tasks. Preprint, arXiv:2604.22750v3.
- Brian Foote, Joseph Yoder (1997/1999). Big Ball of Mud. PLoP ’97, WUCS-97-34; Web 1999; Pattern Languages of Program Design 4, 2000.
- Angular: HTTP Observables / cancellation, Zoneless, Signals / computed, Effects, RxJS interop.
- RxJS: switchMap.