AI와 Big Ball of Mud
빅 볼 오브 머드(Big Ball of Mud)는 이해하기 어렵습니다. 사용자 흐름은 컴포넌트, 서비스, 전역 상태에 흩어집니다. 겉으로 보이는 구조에서는 거의 짐작할 수 없는 곳에서 부작용이 생깁니다. 상속은 도메인상 별 관련 없는 영역을 연결합니다. 국소적으로 보이는 변경이 여러 도메인을 지나는 의존성에 닿을 수 있습니다.
사람에게 이런 분석은 어느 순간 비용이 많이 드는 일이 됩니다. 어느 한 부분이 특별히 복잡해서만은 아닙니다. 관련될 수 있는 수많은 관계를 동시에 따라가야 하는 것이 문제입니다.
그러다 코딩 에이전트가 등장합니다.
리포지터리를 검색하고 참조를 따라갑니다. 서비스, 기반 클래스, 테스트를 열고 호출 사슬을 복원합니다. 상태를 쓰는 곳을 찾고, 앞선 파일이 다른 의존성을 가리키면 다음 파일을 읽습니다.
사람은 어느 순간 “제가 정확히 왜 이 파일에 와 있죠?”라고 묻습니다. 에이전트는 다음 파일을 열 뿐입니다.
사소한 개선이 아닙니다. 특히 강하게 결합된 시스템에서 오늘날의 코딩 에이전트는 사람이 하기에는 매우 힘든 분석을 맡을 수 있습니다. 그래서 리포지터리 수준 벤치마크와 최근 연구는 함수 하나의 생성만 다루지 않습니다. 탐색, 검색, 여러 파일을 넘나드는 추론, 도구 사용, 관련 맥락의 선택을 다룹니다.
기준 시점: 2026년 8월. 이 글은 코딩 에이전트, 맥락 처리 방식, 경제적 조건의 현재 상태를 설명합니다. 5년이나 10년 뒤에 무엇을 할 수 있을지 신뢰할 만하게 말할 사람은 없습니다. 언젠가는 정말 “버리고 새로 만드세요”만 지시하면 될지도 모릅니다. 2026년 8월 현재, 그것은 믿고 따를 아키텍처 전략이 아닙니다.
따라서 질문은 AI가 Big Ball of Mud에서 도움이 되는지 여부가 아닙니다. 이미 도움이 됩니다.
더 흥미로운 질문은 이것입니다. 정확히 무엇을 개선합니까?
괜찮습니다. 이제 AI가 있으니까요.
섹션 제목: “괜찮습니다. 이제 AI가 있으니까요.”코딩 에이전트에는 큰 코드베이스에서 일할 때 Big Ball of Mud에 잘 맞는 성질이 있습니다. 리포지터리 전체를 검색하고, 많은 파일을 살피고, 심벌과 참조를 따라갑니다. 테스트를 실행하고 로그를 해석하며, 한 접근이 실패하면 다른 경로를 시도할 수 있습니다.
무엇보다 분석 결과를 사람의 작업 기억과 같은 방식으로 계속 붙잡고 있을 필요가 없습니다. 맥락을 다시 읽고 검색을 반복하며, 중간 결과를 압축하고, 이미 조사한 경로를 다시 복원할 수 있습니다.
시스템 전체를 ‘이해했다’는 뜻은 아닙니다. 너무 강한 표현입니다. 하지만 명시적인 코드 맥락을 대량으로 기계적으로 검색하고 넓은 검색 공간을 더 빨리 돌아다닐 수는 있습니다.
리포지터리 탐색이 오늘날 에이전트 실행의 상당 부분을 차지할 수 있다는 점은 경험적으로도 관찰됩니다. 2026년 발표된 FastContext 연구는 SWE-bench Multilingual의 코딩 에이전트 실행 궤적 300개를 분석했습니다. 읽기와 검색은 도구 사용 턴의 56.2%, 주 에이전트 토큰의 46.5%를 차지했습니다. 탐색을 분리하고 결과를 압축하자 실험에서 주 모델의 토큰 사용량이 벤치마크에 따라 상당히 줄었고, 가장 좋은 경우 약 60% 감소했습니다. 이 글을 쓰는 시점에는 프리프린트입니다. 그 수치가 보편적이거나 폭넓은 근거가 확립되었다는 뜻은 아닙니다. 다만 관련 코드를 찾는 일 자체가 에이전트 업무의 측정 가능한 부분임을 잘 보여 줍니다.
다른 최근 연구에도 비슷한 결과가 있습니다. ContextSniper는 리포지터리 수준 수정의 예비 실험에서 토큰 사용량을 크게 줄였지만, 제출된 해결안의 해결률(Submitted-Resolution Rate)은 조금 낮았습니다. SWE-ContextBench는 알맞게 선택하고 압축한 경험이 토큰 비용과 실행 시간을 줄일 수 있지만, 가리지 않거나 잘못 고른 맥락은 도움이 적거나 해로울 수 있음을 보여 줍니다. 이 연구들도 아직 초기 단계입니다. 둘 다 2026년 8월 현재 프리프린트입니다.
그러므로 기본 문제는 가정에 그치지 않습니다.
에이전트는 코드를 바꾸기 전에 먼저 어떤 코드가 관련되는지 알아내야 합니다.
Big Ball of Mud는 바로 그 질문을 어렵게 만듭니다.
분석 능력은 아키텍처가 아닙니다
섹션 제목: “분석 능력은 아키텍처가 아닙니다”에이전트가 티켓을 위해 다음 흐름을 복원했다고 가정해 보겠습니다.
A가 B를 호출합니다.
B가 C를 바꿉니다.
C가 D에 부작용을 일으킵니다.
공용 기반 클래스까지 동작을 덮어써서 E도 실행합니다.
에이전트는 이 사슬을 찾습니다. 왜 티켓에 중요한지도 설명할 수 있을지 모릅니다. 테스트를 추가하고 알맞은 곳에 변경을 구현할 수도 있습니다.
가치 있는 일입니다.
하지만 뒤에도 여전히 이것이 남습니다.
A → B → C → D → E
도메인 경계가 더 명확해진 것은 아닙니다. 책임을 새로 나누지 않았고, 의존성에 갑자기 방향이 생기지도 않았습니다. 전역 상태는 전역입니다. 여러 도메인을 결합하는 기반 클래스는 분석에 성공한 뒤에도 여전히 결합합니다.
AI는 부족한 아키텍처를 분석으로 보완할 수 있습니다. 하지만 분석은 아키텍처를 대신하지 않습니다.
의존성 경로를 복원하는 것과 그 경로를 타당하게 제한하는 것은 다릅니다.
이 시리즈에서 이미 중요하게 다룬 메커니즘으로 돌아옵니다. 조직이 구조적 결함을 보완하기 때문에 Big Ball of Mud는 놀랄 만큼 오래 작동할 수 있습니다. 전문가는 위험한 곳을 압니다. 리뷰는 위험을 받아내고 회귀 테스트는 중요한 경로를 보호합니다. 릴리스 절차는 더 신중해집니다. 별것 아닌 듯한 어떤 변경을 피해야 하는지 특정 인물이 압니다.
코딩 에이전트는 새롭고 매우 강력한 보완 방식이 될 수 있습니다.
시스템이 반드시 단순해지는 것은 아닙니다. 그 안에서도 일하는 능력이 좋아질 뿐입니다.
역사가 리포지터리에 없을 때
섹션 제목: “역사가 리포지터리에 없을 때”오래된 시스템에서 특히 놓치기 쉬운 두 번째 문제가 있습니다. 변경에 중요한 모든 것이 현재 코드에 있지는 않습니다.
이 예외 처리는 왜 있습니까? 2019년 운영 장애 때문입니까? 지금은 사라진 기술 제약이 있었습니까? 이상한 추가 요청은 이미 꺼진 백엔드를 위한 우회 방법입니까? 이 if는 실제 도메인 규칙입니까, 오래된 예외일 뿐입니까? 이 의존성은 의도한 것입니까, 시간에 쫓긴 릴리스의 결과입니까?
에이전트는 현재 코드를 분석할 수 있습니다. 접근할 수 있다면 Git 이력, 이슈, ADR, 문서, 로그, 예전 풀 리퀘스트도 조사할 수 있습니다. 많은 산출물을 검색하고 관계를 찾는 일에서도 매우 유용할 수 있습니다.
하지만 핵심 제약은 같습니다. 정보가 어딘가에는 남아 있어야 합니다.
결정을 기록한 적이 없고, 티켓도 사라졌고, 당시 개발자도 회사를 떠나 결과 코드만 남았다면 에이전트는 가설을 세울 수 있습니다. 패턴을 찾고 그럴듯한 설명을 만들 수 있습니다.
사라진 역사를 아무것도 없는 곳에서 신뢰할 만하게 복원할 수는 없습니다.
역사가 어디에도 저장되어 있지 않다면 큰 컨텍스트 윈도도 되찾아 주지 못합니다.
AI만의 문제는 아닙니다. 새로 온 개발자도 같은 한계를 가집니다. 에이전트가 바꾸는 것은 경제적으로 분석할 수 있는 기존 자료의 양뿐입니다.
그래서 에이전트 기반 코딩에서 아키텍처는 흥미로워집니다. 코드의 구조뿐 아니라 필요한 지식의 구조로서 말입니다.
맥락 압축으로서의 아키텍처
섹션 제목: “맥락 압축으로서의 아키텍처”좋은 아키텍처는 유지보수성, 관심사 분리, 정보 은닉, 명확한 책임으로 자주 설명합니다. 코딩 에이전트에는 다른 관점을 더할 수 있습니다.
아키텍처는 관련 검색 범위를 제한합니다.
변경이 planning 도메인과 관련된다고 가정하겠습니다.
잘 나뉜 시스템에는 알아볼 수 있는 planning 슬라이스가 있습니다. 공개 인터페이스는 정의되어 있습니다. 다른 영역과의 의존성은 소수의 통제된 경계를 지납니다. 슬라이스 안에도 이해할 수 있는 레이어와 책임이 있습니다.
국소적 변경을 위해 에이전트는 Planning 슬라이스, 주변 모델 일부, 공개 인터페이스, 관련 테스트를 조사해야 할 수 있습니다. 반면 billing, 사용자 관리, 보고 기능, 다른 독립 영역의 모든 구현 세부사항까지 이해할 필요는 없습니다.
그러므로 경계의 핵심은 포함하는 것만이 아닙니다. 제외하는 것입니다.
아키텍처는 가능성을 제외하는 장치이기도 합니다.
이것만 말하지 않습니다.
Planning은 여기 있습니다.
동시에 이렇게 말합니다.
이 경계를 따르면 이 변경을 위해 나머지 시스템의 큰 부분을 알 필요가 없습니다.
에이전트의 자원에 직접 영향을 주는 형태의 정보 은닉입니다. 모듈화는 다른 영역에서 내부 세부사항을 믿고 무관하게 취급할 수 있는 영역을 만듭니다. LLM보다 훨씬 오래된 원리입니다. 에이전트 기반 코딩은 자원이라는 관점을 더할 뿐입니다.
그래서 일종의 **맥락 압축(Context Compression)**이라고 부를 수 있습니다.
소스 코드를 물리적으로 압축해서가 아닙니다. 훌륭하게 모듈화한 시스템도 수백만 줄일 수 있습니다. 특정 결정에 필요한 시스템의 단면을 압축합니다.
쉽게 말하면 이렇습니다.
좋은 아키텍처는 어떤 것을 믿고 무관하게 취급할 수 있게 해서 맥락을 줄입니다.
수학 법칙으로 오해해서는 안 됩니다. 모듈화한 코드가 낮은 토큰 사용량을 보장하지 않습니다. 복잡한 티켓은 훌륭한 시스템에서도 많은 분석이 필요합니다. 혼란스러운 시스템의 변경도 우연히 완전히 국소적일 수 있습니다.
그래도 컴퓨터과학적 논리로는 개연성이 있습니다. 문제 공간을 잘 나누고 의존성을 잘 제한할수록 국소적 작업과 관련된 검색 범위는 작아질 수 있습니다.
최근 맥락 선택 연구는 이 생각과 잘 맞지만 아키텍처 가설의 직접 증거는 아닙니다. CodexGraph는 명시적인 코드 그래프로 구조 기반 검색과 탐색을 합니다. CodeMEM은 AST 기반 표현으로 리포지터리·세션 맥락을 선택적으로 유지합니다. SWE-ContextBench는 알맞게 선택한 압축된 경험이 가리지 않은 이력보다 효율적일 수 있음을 보여 줍니다.
에이전트가 관련 맥락을 찾고, 구조화하고, 압축하는 방법은 이미 활발히 연구하고 있습니다.
아키텍처는 다른 수준에서 같은 질문에 답합니다.
이 작업에 대체 무엇이 관련될 수 있습니까?

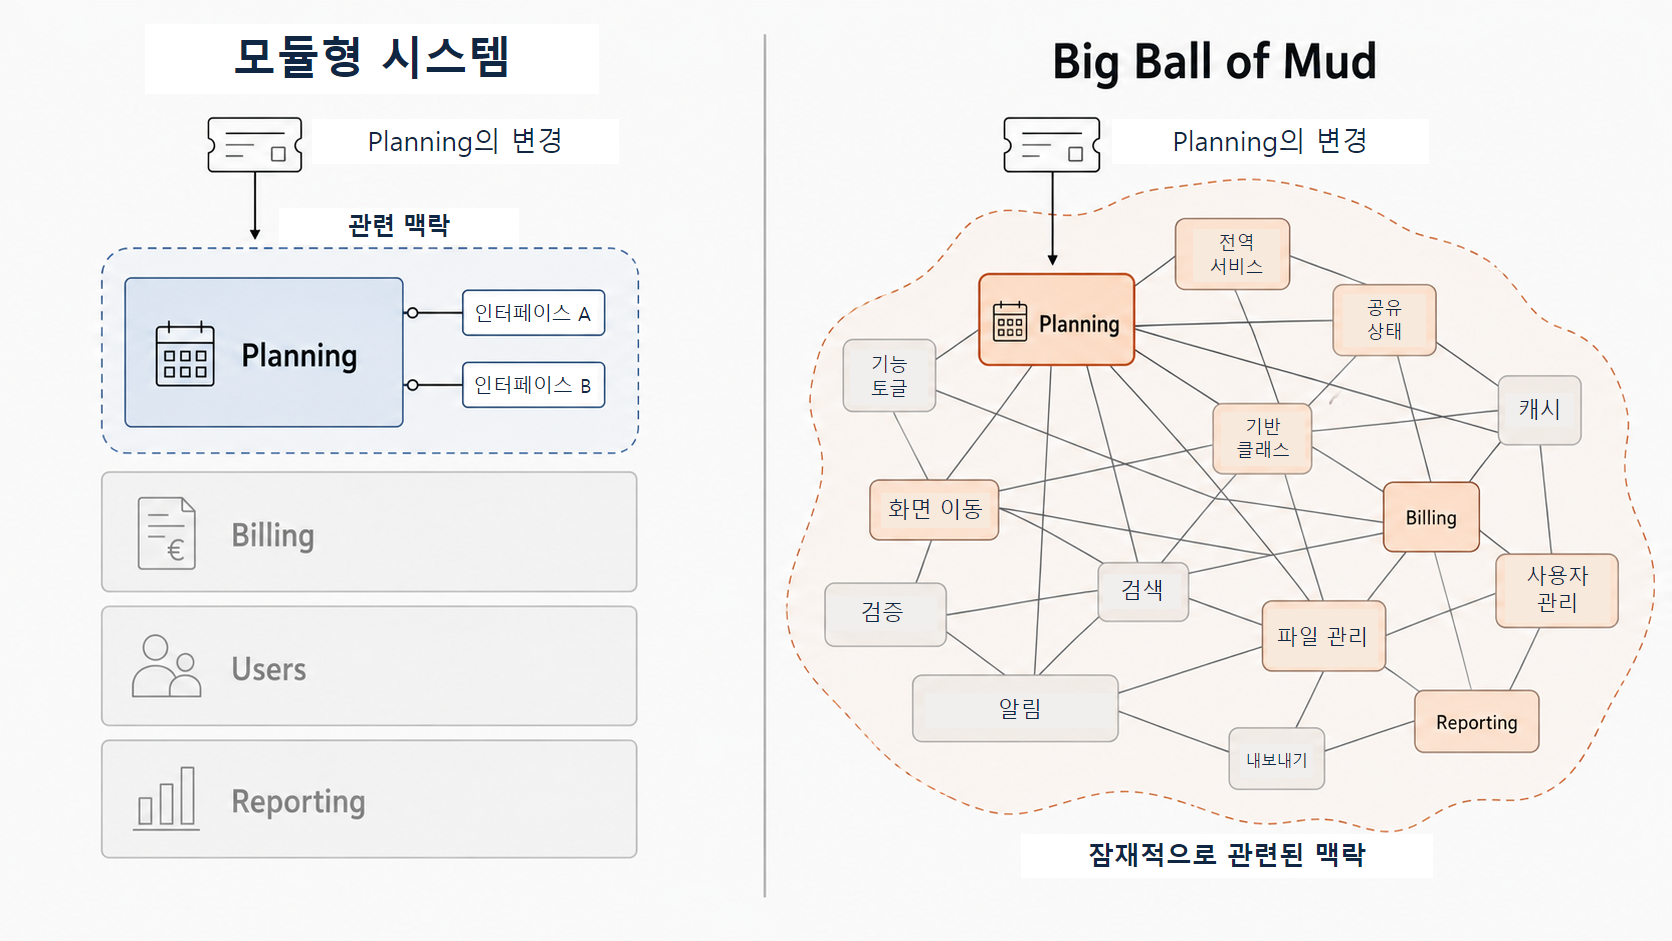
좋은 아키텍처는 코드의 양을 줄이지 않습니다. 변경을 위해 알아야 하는 코드의 범위를 줄입니다.
Big Ball of Mud에는 바로 그 경계가 없습니다
섹션 제목: “Big Ball of Mud에는 바로 그 경계가 없습니다”같은 변경을 Big Ball of Mud에서 보겠습니다.
파일 A에서 시작합니다. A는 서비스 B를 사용합니다. B는 전역 상태 C에 씁니다. 쓰기에 다른 컴포넌트가 반응합니다. C는 기반 클래스의 동작을 상속합니다. 기반 클래스는 화면 이동, 설정, 여러 도메인의 기능을 압니다. 두 번째 슬라이스가 다른 경로로 같은 상태를 바꿉니다. 자체 인프라가 그 변경 일부에 다시 반응합니다.
에이전트가 검색할 수 없는 구조는 아닙니다. 바로 그것이 강점입니다. A를 보고 B를 열고, C를 쓰는 곳을 검색하고, 상속을 따라가고, 누가 또 C를 바꾸는지 확인할 수 있습니다.
하지만 새 관계를 찾을 때마다 다른 관련 후보가 열릴 수 있습니다.
에이전트는 그 공간을 검색할 수 있습니다.
하지만 검색해야 합니다.
모듈형 시스템이라면 이상적으로는 어느 순간 믿을 만한 경계에 도달합니다. 공개 API, 방향이 정해진 의존성, 슬라이스 경계가 있으므로 그 뒤의 세부사항은 이 변경과 무관하다고 결론 내릴 수 있습니다.
Big Ball of Mud에서는 그 경계부터 찾아야 할 때가 많습니다. 믿을 만한 경계가 없을 수도 있습니다.
그렇다고 탐색 작업이 수학적으로 지수 증가한다고 결론 내릴 수는 없습니다. 그럴 근거가 없습니다. 다만 새 의존성마다 관련 검색 공간에 새 후보가 들어오면 상당히 커질 수 있습니다.
최근 리포지터리 수준 연구도 큰 컨텍스트 윈도가 문제를 그냥 없애 주지는 않음을 보여 줍니다. FSE 2026에 발표된 RepoReasoner는 파일 간 추론과 호출 사슬을 명시적으로 다룹니다. 정답에 필요한 Oracle 맥락을 제공해도 어려운 파일 간 작업은 어렵습니다. 자료가 많으면 잡음도 늘 수 있어 맥락이 길다고 늘 결과가 좋아지지는 않습니다.
그러므로 질문은 이것만이 아닙니다.
전체 리포지터리가 컨텍스트 윈도에 들어갑니까?
이 질문입니다.
그중 어떤 부분이 이 결정을 하는 에이전트에게 도움이 됩니까?
좋은 아키텍처에서도 에이전트 기반 코딩은 비쌉니다
섹션 제목: “좋은 아키텍처에서도 에이전트 기반 코딩은 비쌉니다”여기서 높은 토큰 사용량을 곧 나쁜 아키텍처로 해석하고 싶어질 수 있습니다.
잘못입니다.
훌륭하게 구조화한 시스템에서도 자원을 많이 쓸 수 있습니다. 에이전트는 코드를 읽고 계획하고 구현하고 컴파일합니다. 테스트를 실행하고 오류를 분석하고 수정하고 다시 테스트합니다. 패치를 평가하고 리뷰 결과에 대응합니다. 여러 단계의 에이전트는 하위 에이전트를 시작하거나, 여러 접근을 따르거나, 예산의 상당 부분을 검증에 쓸 수도 있습니다.
2026년 제시된 Tokenomics 연구는 다중 에이전트 개발 워크플로의 토큰 분포를 분석합니다. 조사한 30개 작업에서는 평균적으로 반복 코드 리뷰 단계가 가장 큰 비중을 차지했습니다. 작고 특정한 연구입니다. 에이전트 기반 코딩의 일반 비용 공식은 아닙니다. 다만 ‘많은 토큰’이 우선 ‘많이 일했다’는 뜻일 수 있는 이유를 보여 줍니다.
아키텍처 비교는 더 정확한 질문에서 시작합니다.
어떤 부분이 작업과 관련되는지 처음 알아내야 하기 때문에만 생기는 추가 작업은 얼마나 됩니까?
좋은 아키텍처는 토큰 사용량 자체를 최소화하지 않습니다. 하지만 국소적 변경을 위해 시스템을 새로 파악하는 데만 필요한 비중을 줄일 수 있습니다.
중요한 것은 ‘싸다/비싸다’보다, 생산적인 맥락과 탐색 비용을 구분하는 일입니다.
그래도 AI는 if를 하나 더 넣을 수 있습니다
섹션 제목: “그래도 AI는 if를 하나 더 넣을 수 있습니다”다음 티켓이 옵니다.
특정 상태를 추가 조건 세 개 아래에서 다르게 처리해야 합니다. 비슷한 예외는 이미 많습니다.
에이전트는 조건을 검색합니다. 같은 상태를 읽고 바꾸는 곳을 찾고 기존 관례를 파악합니다. 기존 동작에 가장 적은 위험으로 맞는 자리에 예외를 넣습니다. 테스트도 보강합니다.
테스트는 통과합니다. 티켓은 끝났습니다.
그리고 시스템에는 어쩌면 38번째 예외가 생겼습니다.
에이전트는 좋은 국소적 해법을 아주 빨리 찾을 수 있습니다. 역사적으로 바로 그것도 문제의 일부였습니다.
앞선 형성 과정의 글은 이 메커니즘을 다뤘습니다. 아침부터 이해할 수 없는 아키텍처를 만들겠다고 정하는 사람은 없습니다. 개별 결정은 국소적으로 전적으로 합리적일 수 있습니다. 시간에 쫓겨 기존 구조를 확장합니다. 해법은 작동합니다. 예외가 하나 더 생깁니다. 나중의 정비는 이루어지지 않습니다.
에이전트가 우선 그 과정을 바꾸는 것은 아닙니다.
일을 잘못했다는 뜻도 아닙니다. 오히려 받은 작업을 정확하게 수행했을 수 있습니다.
기존 시스템에서 가능한 한 위험이 작게 이 티켓을 구현하세요.
국소적으로 가장 안전한 변경이 또 하나의 if라면, 좋은 에이전트는 바로 그 if를 아주 효율적으로 찾을 수 있습니다.
문제는 최적화의 수준입니다. 국소적으로 최적화한 패치는 자동적인 아키텍처 개선이 아닙니다.

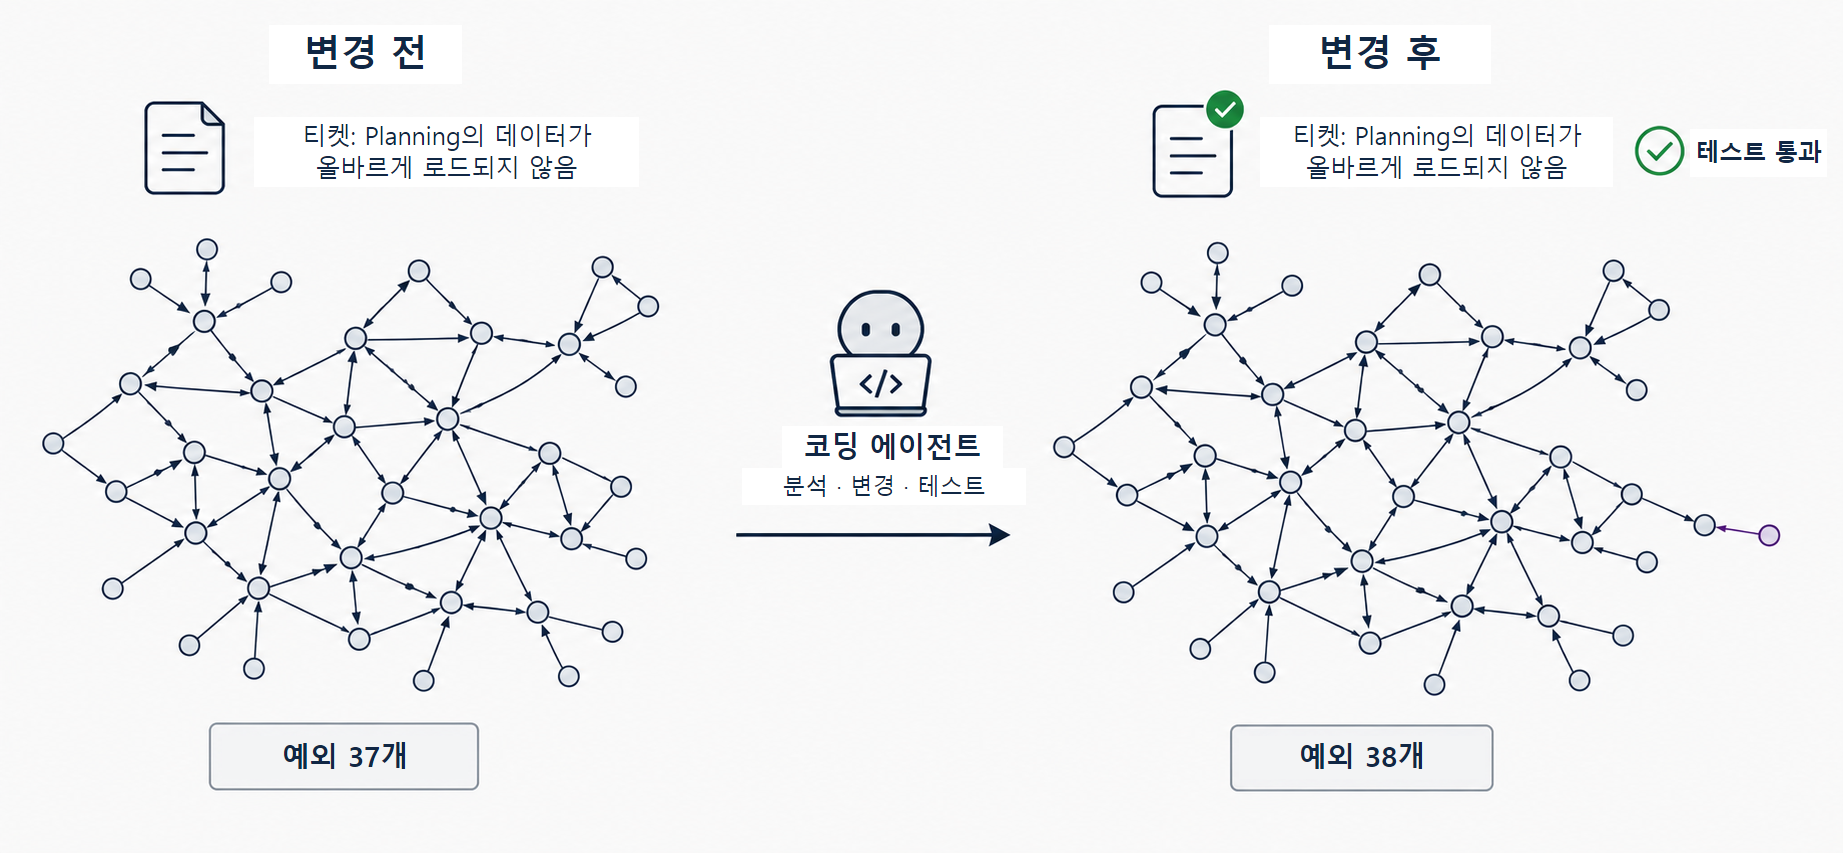
성공적인 변경이 곧 구조적 개선은 아닙니다.
새로운 보완 층으로서의 AI
섹션 제목: “새로운 보완 층으로서의 AI”여기서 Big Ball of Mud에 관한 흥미로운 가설이 생깁니다.
지금까지 이런 시스템을 오래 발전시킬 수 있었던 이유 중 하나는 다른 장치가 결함을 메웠기 때문입니다. 숙련된 전문가가 위험한 곳을 알고, 광범위한 회귀 테스트가 변경을 보호했습니다. 리뷰가 부족한 국소적 이해 가능성을 보완하고, 릴리스 관행이 위험을 줄였습니다. 개인의 지식이 문서를 대신하고 우회 방법이 구조적 결함을 이어 주었습니다.
이제 에이전트 분석이 또 하나의 보완 층이 될 수 있습니다.
경계 붕괴를 없애지는 않습니다. 하지만 그 상태에서도 특정 변경을 하는 데 드는 작업을 우선 줄입니다.
경제적으로 흥미로운 가능성이 생깁니다.
AI가 Big Ball of Mud의 경제적 한계점을 뒤로 미룰 수 있습니다.
사람만으로는 변경 비용이 이미 지나치게 높았을 시스템도 에이전트의 지원으로 더 오래 생산적으로 발전시킬 수 있을지 모릅니다.
현재로서는 가설이지 입증된 법칙이 아닙니다. 특히 구조가 서로 다른 실제 코드베이스의 직접 비교는 아직 충분히 연구되지 않았습니다.
하지만 메커니즘은 개연성이 있습니다. 분석이 비싼데 새 도구가 더 싸게 해 주면, 우선 변경 비용이 내려갑니다. 시스템 자체가 더 좋아질 필요는 없습니다.
Big Ball of Mud가 건강해지는 것은 아닙니다. 더 오래 일할 수 있는 상태로 남을 뿐입니다.

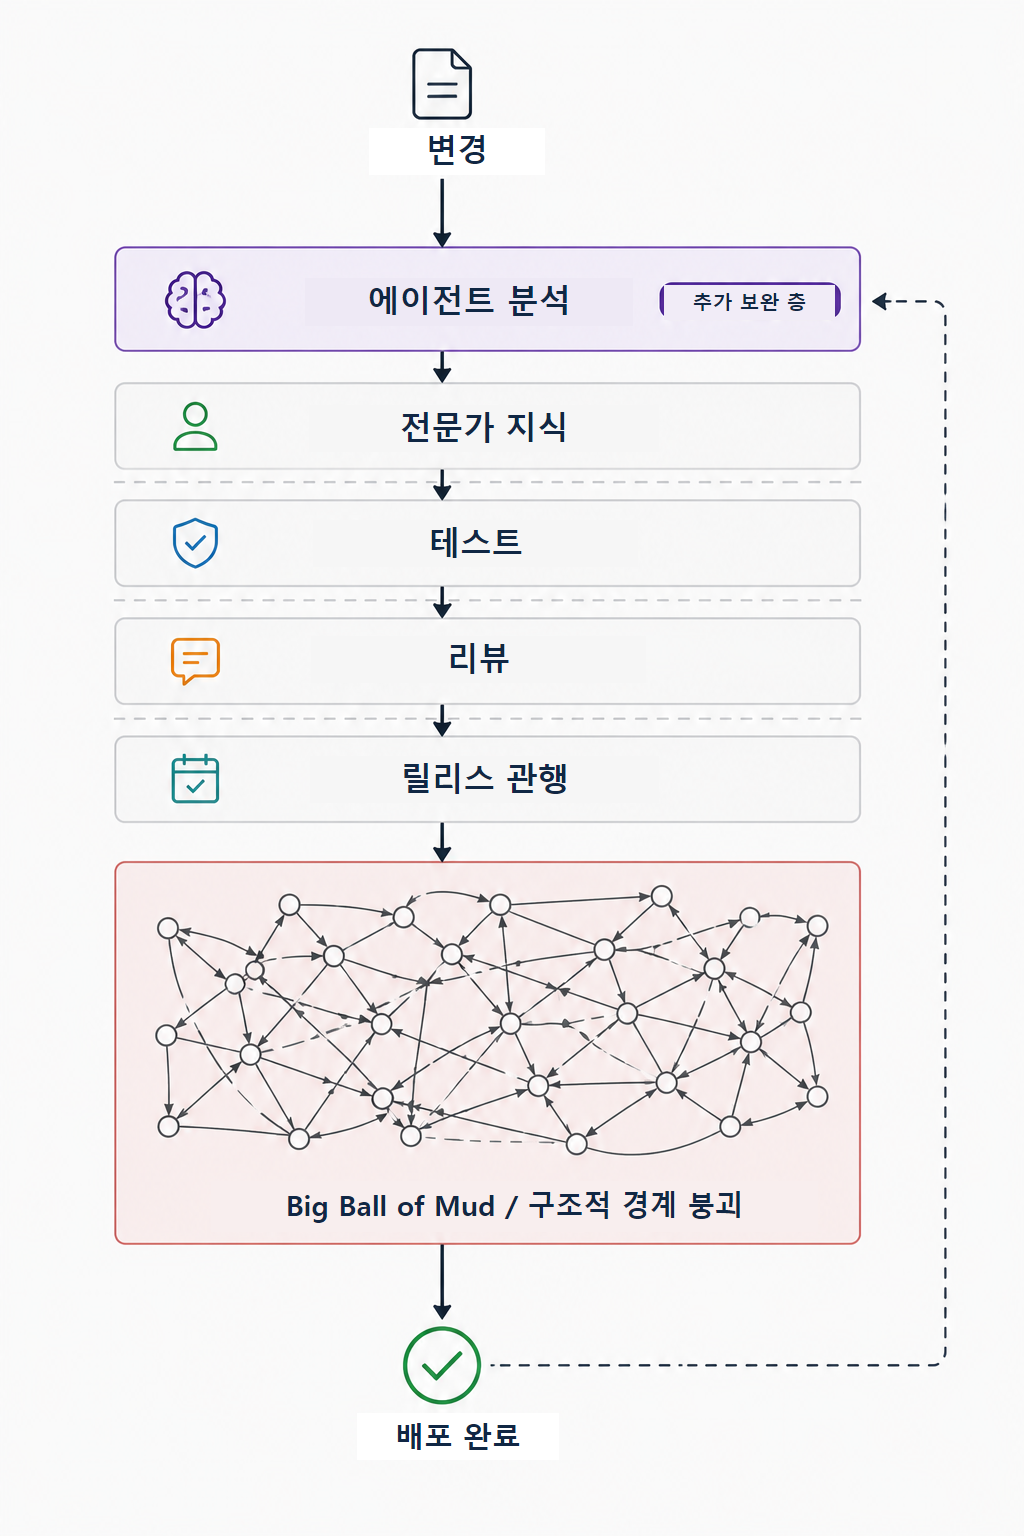
AI는 구조를 바꾸지 않고도 부족한 구조의 결과를 보완할 수 있습니다.
하루 만에 쓴 한 달 사용량
섹션 제목: “하루 만에 쓴 한 달 사용량”저도 경계가 특히 심하게 무너진 시스템에서 이 변화를 경험했습니다.
하루 근무 시간 안에 당시 Windsurf 요금제에서 대략 한 달치로 예정된 에이전트 사용량을 다 썼습니다.
시스템을 다시 작성하라고 시킨 것이 아닙니다. 주로 이해하는 일을 맡겼습니다.
검색하고 파일을 읽고 의존성을 따라갔습니다. 새 발견은 다른 파일로 이어졌습니다. 가정을 검증하고 일부는 다시 버려야 했습니다. 에이전트는 할 수 있었고 매우 유용했습니다.
다만 분석은 무료가 아니었습니다.
이 경험은 일반 비용 함수를 뒷받침하는 경험적 근거가 아닙니다. 모든 Big Ball of Mud가 비슷한 토큰을 필요로 한다거나, 비교할 모듈형 코드가 특정 배수만큼 저렴했을 것이라고 결론 내릴 수는 없습니다.
그래도 관찰로서는 흥미롭습니다. 예전에는 거의 사람의 분석 시간으로만 보였을 복잡성 비용 일부가 갑자기 다른 자원인 에이전트 사용량으로 나타났기 때문입니다.
제게 ‘맥락 압축으로서의 아키텍처’가 이론적인 생각에서 꽤 구체적인 경제적 질문이 된 순간이었습니다.
지금 연구가 보여 주는 것과 아직 보여 주지 못하는 것
섹션 제목: “지금 연구가 보여 주는 것과 아직 보여 주지 못하는 것”코딩 에이전트 연구는 너무 빠르게 발전해서 이 절은 다른 부분보다 빨리 낡을 가능성이 큽니다. 그래도 2026년 8월 현재 몇 가지 층위는 비교적 분명하게 나눌 수 있습니다.
리포지터리 탐색에는 측정 가능한 비용이 있습니다
섹션 제목: “리포지터리 탐색에는 측정 가능한 비용이 있습니다”관련 파일과 코드 영역부터 찾아야 한다는 사실은 이미 리포지터리 수준 연구의 일부입니다. FastContext는 도구 호출과 토큰 사용에서 읽기·검색 활동의 큰 비중을 측정합니다. ContextSniper는 리포지터리와 도구 출력을 선택해 토큰을 줄입니다. CodexGraph는 리포지터리의 명시적 구조 표현으로 탐색과 검색을 돕습니다.
구체적인 수치를 보편적으로 옮겨 쓸 수는 없습니다. 모델, 에이전트 하니스, 벤치마크, 작업이 다르면 실행 궤적도 다릅니다.
하지만 기본적으로 중요한 관찰은 남습니다.
탐색은 실제 프로그래밍에 앞선 무료 준비 단계가 아닙니다. 에이전트 업무의 일부입니다.
최대 맥락량보다 맥락 선택이 중요합니다
섹션 제목: “최대 맥락량보다 맥락 선택이 중요합니다”2025년 Findings of NAACL에 발표된 RepoExec 연구는 리포지터리 수준 코드 생성이 적절한 의존성 맥락에 크게 좌우됨을 보여 줍니다. 그래서 다른 최근 연구는 관련 정보를 선택하고 구조화하며 여러 상호작용 동안 유지하는 방법을 명시적으로 조사합니다.
SWE-ContextBench는 올바르게 선택하고 요약한 과거 경험이 실행 시간과 토큰 비용을 줄일 수 있지만, 가리지 않은 맥락의 효과는 작거나 부정적이라고 보고합니다. LoCoBench-Agent는 철저한 탐색과 효율 사이의 트레이드오프를 관찰합니다. 탐색을 늘리면 이해가 나아질 수 있지만 상호작용과 자원이 추가로 필요합니다. 두 연구 모두 이 글을 쓰는 시점에 프리프린트입니다.
큰 컨텍스트 윈도도 이 문제를 없애지 않습니다. RepoReasoner는 복잡한 파일 간 작업에서 여전히 뚜렷한 한계를 보여 주며, 잡음이 더해질 때 긴 맥락이 일관되게 더 좋은 결과를 내지는 않는다고 보고합니다.
구조화된 표현이 도움이 될 수 있습니다
섹션 제목: “구조화된 표현이 도움이 될 수 있습니다”여러 연구가 리포지터리 구조를 더 명시적으로 활용하게 하려 합니다.
CodexGraph는 코드 관계를 그래프로 모델링하고 구조 기반 질의를 허용합니다. CodeMEM은 AST 기반 기억 구조로 리포지터리·세션 맥락을 다룹니다. 2026년 6월의 또 다른 연구는 시각적 리포지터리 그래프의 추가 사용을 조사했습니다. 시험한 시나리오에서는 텍스트 도구에 그래프를 더했을 때 성공률을 유지하거나 높이면서 입력 토큰이 최대 26% 줄었습니다. 이 연구는 프리프린트입니다.
아직 “깔끔한 아키텍처가 토큰 X%를 아낀다”는 증거는 아닙니다.
하지만 리포지터리 맥락을 구조화하고 범위를 제한하는 일이 경험적으로 중요하다는 점은 보여 줍니다.
직접적인 아키텍처 비교는 아직 없습니다
섹션 제목: “직접적인 아키텍처 비교는 아직 없습니다”따라서 이 글의 핵심 주장에는 선을 그어야 합니다.
조사 과정에서 저는 기능적으로 비교 가능한 시스템이면서 내부 아키텍처가 크게 다른 경우, 예컨대 일관되게 모듈화한 시스템과 경계가 크게 무너진 Big Ball of Mud를 동일한 에이전트 작업으로 비교하고 토큰, 도구 호출, 탐색 작업을 측정한 통제 연구를 찾지 못했습니다.
중요한 점입니다.
현재 연구를 통해 리포지터리 탐색에 자원이 필요하고, 무관한 맥락이 문제가 될 수 있으며, 더 나은 선택과 구조화된 표현으로 측정 가능한 효율 이득을 얻을 수 있다고는 말할 수 있습니다.
하지만 이런 경험적으로 확립된 공식은 아직 도출할 수 없습니다.
Big Ball of Mud에서는 코딩 에이전트의 토큰이 다섯 배 더 듭니다.
이것은 더더욱 아닙니다.
Big Ball of Mud는 토큰을 지수적으로 더 많이 씁니다.
2026년 8월 현재 그런 근거는 없습니다.
그래서 이 글의 주장은 세 층위에 머뭅니다.
- 컴퓨터과학적 논리: 제한된 의존성은 국소적 작업과 잠재적으로 관련된 검색 공간을 제한할 수 있습니다.
- 인접한 경험적 근거: 리포지터리 탐색, 맥락 선택, 긴 에이전트 실행 궤적에는 측정 가능한 토큰·실행 시간·도구 비용이 있습니다.
- 열린 연구 질문: 다른 조건이 비슷한 작업에서 소프트웨어 아키텍처의 차이가 실제로 에이전트 자원 소비에 얼마나 영향을 주는가입니다.
가설이 그럴듯하게 들리기 때문에 더욱 이 층위들을 혼동해서는 안 됩니다.
청구 단위에 토큰, 맥락, 연산량이 더해집니다
섹션 제목: “청구 단위에 토큰, 맥락, 연산량이 더해집니다”나쁜 아키텍처의 비용은 새롭지 않습니다. 다른 단위로 보였을 뿐입니다.
개발자는 분석과 변경에 더 오래 걸립니다. 리드 타임이 늘고 오류와 회귀 가능성이 높아집니다. 온보딩이 길어집니다. 전문가가 병목이 되고 리뷰가 어려워집니다. 릴리스에는 추가 안전장치가 필요합니다.
에이전트 기반 코딩은 이 비용 모델에 자원을 더합니다. 입력 토큰, 출력 토큰, 캐시된 맥락, 검색, 도구 호출, 에이전트 실행, 연산량, 실행 시간입니다. 그 뒤에도 사람의 리뷰와 수정 반복은 여전히 필요합니다.
모든 공급업체가 모든 자원을 따로 청구하지는 않습니다. 묶는 것도 있고, 캐싱으로 저렴해지는 것도 있으며, 사용량 한도나 정액 요금 뒤로 숨는 것도 있습니다. 그래도 기술적으로 소비됩니다.
AI가 Big Ball of Mud를 무료로 이해하게 해 주지는 않습니다. 이제 사람의 주의력만으로 비용을 내지 않게 되어 가는 것입니다.
기술 부채에 관한 흥미로운, 아직은 가설적인 관찰값이 생깁니다.
변경 하나에 ‘시스템 이해’가 얼마나 필요한지는 측정하기 어렵습니다. 반면 에이전트는 토큰, 캐시 사용, 도구 호출, 실행 시간, 맥락 크기, 탐색 궤적 등 점점 더 상세한 사용 데이터를 만듭니다.
지금까지 잘 보이지 않던 기술 부채의 일부를 미래에는 적어도 부분적으로 더 측정할 수 있을지 모릅니다.
국소적 변경을 충분히 안전하게 하기 전에 이 시스템에는 기계적 맥락이 얼마나 필요합니까?
보편적 아키텍처 지표는 아닐 것입니다. 시스템 구조가 좋아도 어려운 기능은 어렵습니다. 모델과 에이전트 하니스도 크게 다릅니다. 토큰은 인지적 복잡성의 표준 단위가 아닙니다.
그래도 추가 관찰값으로는 흥미로울 수 있습니다.

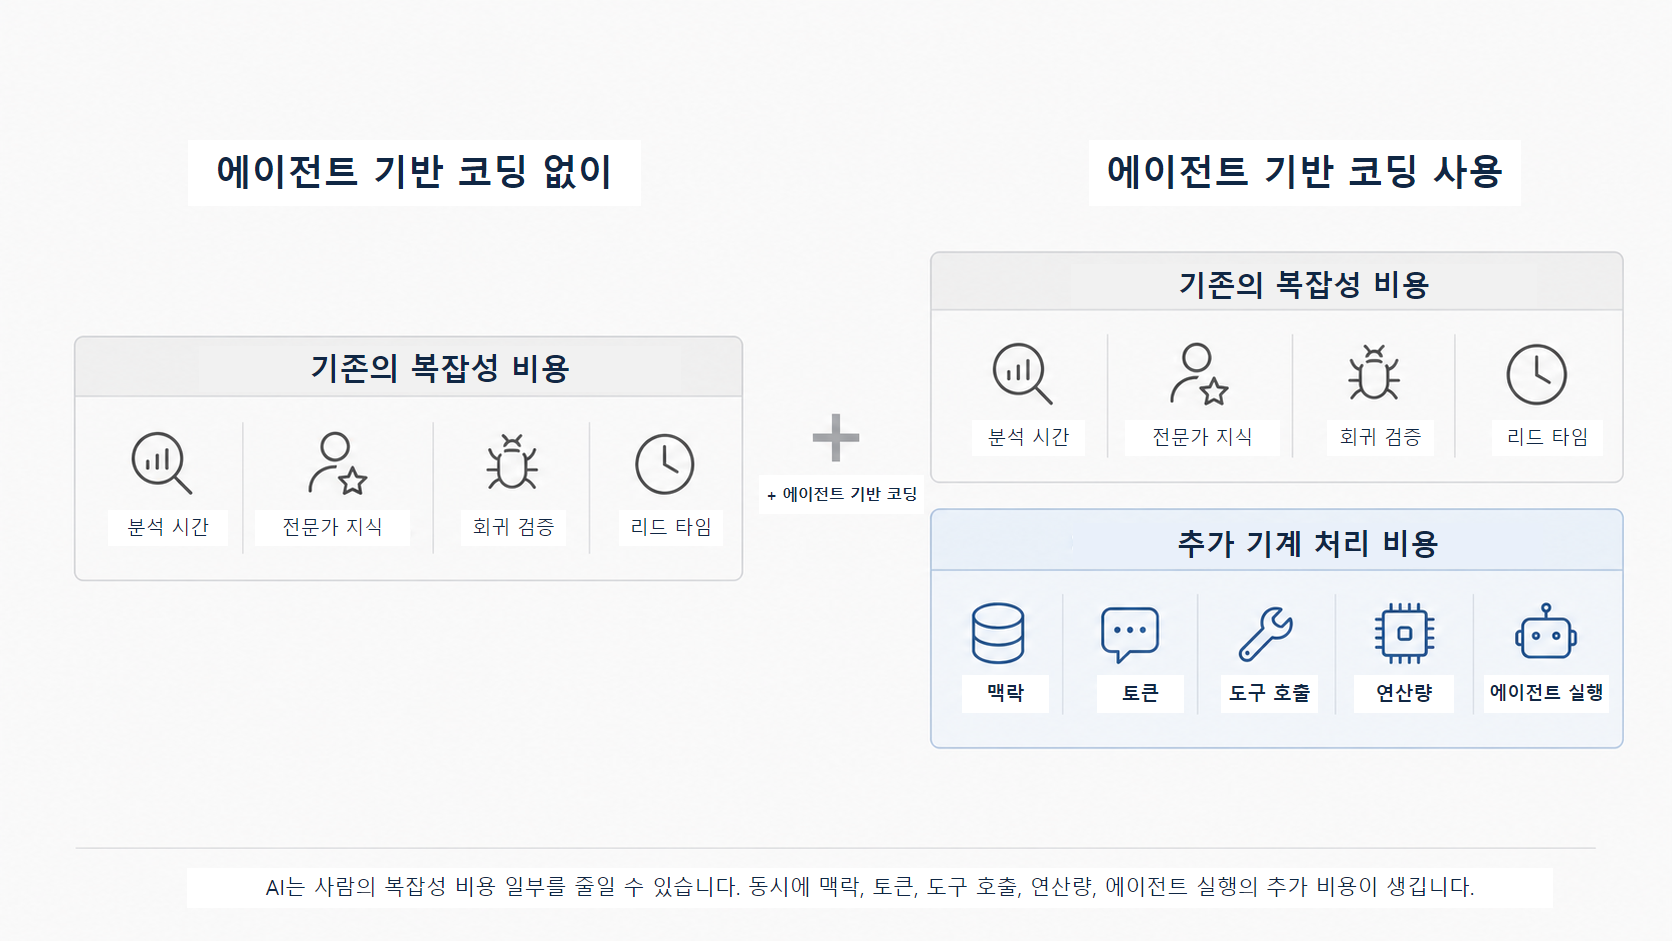
AI가 복잡성 비용을 반드시 없애지는 않습니다. 일부를 기계적 처리로 옮길 수 있습니다.
정액 요금의 효과
섹션 제목: “정액 요금의 효과”오랫동안 이 관계는 놀랄 만큼 쉽게 보이지 않았습니다.
개발자가 AI 도구에 매달 정액을 냅니다. 여러 티켓을 처리합니다. 월말에도 같은 구독료가 나옵니다.
개발자의 관점에서 비용 함수는 우선 단순해 보입니다.
AI는 한 달에 X유로입니다.
하지만 특정 변경에 기계가 얼마나 일했는지는 거의 말해 주지 않습니다.
구독 모델은 포함 사용량, 크레딧, 세션·주간 한도, 공정 사용 규칙, 모델 등급으로 실제 자원 소비를 추상화합니다. 한도를 넘으면 추가 사용이 제한되거나 사용량에 따라 청구될 수 있습니다.
2026년 주요 공급업체의 변화는 정액과 실제 소비의 구분이 지금 재조정되고 있음을 분명히 보여 줍니다.
GitHub는 2026년 6월 1일부터 일반 Copilot 요금제를 GitHub AI Credits 기반 사용량 모델로 바꿨습니다. 입력·출력·캐시 토큰과 각 모델 가격을 기준으로 계산합니다. GitHub는 긴 에이전트 세션의 연산·추론 요구가 훨씬 높고, 이전 Premium Request 모델로는 그 차이를 지속 가능하게 반영하지 못했다고 명시적으로 설명했습니다. 일부 연간 구독은 한동안 이전 요청 모델을 유지했습니다.
그 레거시 모델이 숫자를 신중하게 다뤄야 하는 좋은 예입니다. 2026년 8월 GitHub는 남아 있는 연간 레거시 요금제에서 GPT-5.5의 Premium Request 배수를 57로 표시합니다.
이것은 ‘GPT-5.5 토큰이 57배 비싸졌다’는 뜻이 아닙니다.
종료되어 가는 요청 모델의 특정 청구 단위에 붙은 배수입니다. 토큰 가격, 요청 배수, 포함 크레딧, 실제 추론 비용은 서로 다른 값입니다.
포함 사용량과 더 강한 사용량 기반 확장을 결합하는 기본 패턴은 다른 곳에서도 나타납니다.
OpenAI는 2026년 4월 Codex 청구를 입력·캐시 입력·출력 토큰에 직접 연결된 크레딧 요율표로 바꿨습니다. Codex는 여러 ChatGPT 요금제에 계속 포함됩니다. 포함 한도 이후에는 요금제에 따라 추가 크레딧을 쓸 수 있습니다. 실제 크레딧 소비는 작업의 토큰 구성에 직접 좌우됩니다.
Anthropic도 유료 Claude 요금제와 사용량 한도를 결합합니다. 개인 요금제의 Claude와 Claude Code는 사용 한도를 공유합니다. 도달한 뒤에는 요금제에 따라 Usage Credits를 활성화하거나 사용량 기반 API로 바꿀 수 있습니다. Anthropic은 상호작용의 길이와 복잡성, 모델, 사용 기능 등이 사용량에 영향을 준다고 설명합니다.
현재 구독이 공급업체에 반드시 적자라는 뜻은 아닙니다. 필요한 내부 비용·사용 데이터가 없습니다.
뜻하는 것은 이것뿐입니다.
구독 가격과 특정 작업에 실제로 필요한 기계 작업량은 같은 값이 아닙니다.
아키텍처 비용이 구독료 속으로 사라질 때
섹션 제목: “아키텍처 비용이 구독료 속으로 사라질 때”두 팀을 떠올려 보겠습니다.
A팀은 명확한 도메인 경계와 방향이 정해진 의존성이 있는 모듈형 시스템에서 일합니다. B팀은 경계가 크게 무너진 시스템에서 일합니다. 같은 코딩 에이전트 제품을 사용합니다.
비용 항목에서 같은 월 구독료만 보면 AI 비용은 같아 보입니다.
자원 소비까지 같다는 뜻은 아닙니다.
A팀은 예산의 큰 부분을 구현, 테스트, 리뷰에 쓸 수 있습니다. B팀은 어떤 파일, 서비스, 상태, 부작용이 관련되는지 처음 찾는 데 더 큰 부분을 쓸 수 있습니다.
실제 시스템에서 차이가 작을지 매우 클지는 아직 경험적으로 모릅니다.
하지만 사용량이 더 투명해지고 청구가 더 사용량에 연동되면 경제적 논리는 바뀝니다. 제품과 청구 모델에 따라 추가 검색, 더 큰 맥락, 추가 실행, 더 긴 연산 시간이 직접 비용이 될 수 있습니다.
그러면 이전에는 개발 시간, 좌절, 암묵적 전문 지식에 숨어 있던 것이 더 잘 보일 수 있습니다.
나쁜 아키텍처의 비용은 사라지지 않습니다. AI 정액 요금은 지금 어떤 단위로 내는지 가릴 뿐일 수 있습니다.
몇 년 뒤에는 기술 부채를 다르게 이야기할지도 모릅니다. 이것만 묻지 않을 수 있습니다.
개발자가 이 변경을 하는 데 얼마나 걸립니까?
이것도 물을 수 있습니다.
변경의 범위를 정하기 위해 우리 개발 시스템은 얼마나 많은 맥락과 기계적 탐색이 필요합니까?
Big Ball of Mud는 원래 비쌌습니다. 에이전트 기반 코딩은 청구서의 일부가 시간뿐 아니라 토큰과 연산량으로도 나오게 할 수 있습니다.
“에이전트는 잘 처리하잖아요”
섹션 제목: ““에이전트는 잘 처리하잖아요””어쩌면 가장 위험한 오해가 여기에 있습니다.
문제 있는 레거시 시스템의 변경에 전에는 며칠이 걸렸다고 가정하겠습니다. 좋은 코딩 에이전트를 쓰자 비슷한 티켓이 갑자기 몇 시간 안에 됩니다.
실제 생산성 향상입니다.
하지만 경영 관점에서는 매력적인 해석이 나옵니다.
그렇다면 아키텍처 문제가 그렇게 중요하지는 않은 모양입니다.
보이는 증상이 줄기 때문입니다. 개발자가 이틀 동안 리포지터리를 헤매지 않아도 됩니다. 에이전트가 탐색의 상당 부분을 맡아 전역 상태와 기반 클래스를 찾고, 부작용을 복원하고, 테스트를 만들고, 다음 예외를 구현합니다.
시스템은 다시 빨리 결과를 냅니다.
하지만 슬라이스를 복원하거나 레이어를 도입하거나 오너십을 정리한 것은 아닙니다. 전역 의존성을 줄이지 않았고, 오래된 우회 방법을 없애거나 목표 아키텍처를 만들지도 않았습니다.
에이전트가 시스템 안에서 길을 찾는다고, 시스템에 다시 지속 가능한 구조가 생긴 것은 아닙니다.
조직적으로는 반대 상황도 생각할 수 있습니다. AI가 증상을 성공적으로 보완할수록 단기적으로 구조적 원인을 다뤄야 한다는 경제적 압박이 줄어들 수 있습니다.
이것도 우선 가설입니다. 하지만 원래 Big Ball of Mud를 안정시킨 패턴과 같습니다. 보완 장치가 충분히 저렴한 동안 기존 시스템을 합리적으로 계속 운영할 수 있습니다.
따라서 에이전트는 생산성만이 아니라 나쁜 아키텍처가 경제적으로 감당할 수 없게 되는 시점도 바꿀지 모릅니다.
AI가 벗어나는 길에도 도움을 줄 수 있습니까?
섹션 제목: “AI가 벗어나는 길에도 도움을 줄 수 있습니까?”네. 아마 상당히 도움이 될 것입니다.
에이전트를 강력한 보완 층으로 만드는 같은 능력은 아키텍처 작업에도 흥미롭습니다. 의존성 구조를 분석하고, 이력에서 변경 결합을 조사하고, 사용자 흐름을 복원하고, 코드의 중력 중심을 찾을 수 있습니다. 테스트를 만들고 리팩터링을 검증하며 단계적 마이그레이션에서 새 경계를 아직 위반하는 의존성을 반복해서 확인할 수 있습니다.
아키텍처 복원(Architecture Recovery)도 자연스러운 활용처입니다. 보이는 아키텍처를 잃은 시스템에서 기계적 분석은 실제로 작용하는 구조를 다시 드러내는 데 도움이 됩니다. 코드 그래프, 리포지터리 표현, 맥락을 고려한 탐색 연구는 그런 구조 정보가 에이전트에 유용할 수 있음을 보여 줍니다.
차이는 도구보다 지시에 있습니다.
“기존 시스템에서 이 티켓을 구현하세요.”
이는 능력을 주로 보완 장치로 사용합니다.
“이 시스템의 구조를 이해하고 믿을 만한 경계를 되살리도록 도와주세요.”
이는 같은 능력을 아키텍처 작업에 사용합니다.
둘 다 의미 있을 수 있습니다. 목표가 전혀 다를 뿐입니다.
Big Ball of Mud를 어떻게 분석하고, 어떤 경계를 되살릴 수 있으며, 언제 개선이 교체보다 경제적으로 타당한지는 뒤의 실천 글들에서 다루겠습니다.
AI가 실제로 바꾸는 것
섹션 제목: “AI가 실제로 바꾸는 것”AI는 Big Ball of Mud에 흥미로운 양면성을 만듭니다.
사람만으로는 분석이 이미 매우 비싼 시스템도 계속 변경할 수 있게 할 수 있습니다. 더 많은 코드를 더 빨리 보고, 참조를 따라가고, 제약을 모으고, 의존성을 복원할 수 있습니다. 테스트를 보강하고, 일부 레거시에서는 몇 년 전만 해도 상상하기 어려웠던 속도로 국소적 변경을 할 수 있습니다.
큰 능력입니다. 작게 볼 이유는 없습니다.
동시에 구조적 문제는 사라지지 않습니다. 에이전트는 없는 경계를 계속 보완해야 합니다. 맥락을 찾고 선택하고 처리해야 합니다. 도구 호출, 토큰, 연산량, 실행 시간이 필요합니다. 다음 티켓이 다시 작동하는 한, 바로 그 성공적인 보완이 근본 아키텍처 문제를 다룰 당장의 압박을 줄일 수 있습니다.
따라서 AI는 Big Ball of Mud를 더 다루기 쉽게 하면서도 Big Ball of Mud인 정도를 줄이지 않을 수 있습니다.
미래 에이전트가 큰 레거시 시스템을 대체로 자율적으로 분석하고, 숨은 도메인 모델을 복원하고, 안전한 구조 변환을 수행할 수 있을지는 열려 있습니다. 2026년 8월 현재는 거기에 도달하지 않았습니다.
이미 보이는 변화는 더 미묘합니다.
AI는 Big Ball of Mud의 끝을 뜻하기보다, 우선 수명을 늘릴 수 있습니다.
에이전트는 오늘도 진흙 속에서 놀랄 만큼 많은 길을 찾습니다. 그렇다고 땅이 마르는 것은 아닙니다.
출처와 연구 현황
섹션 제목: “출처와 연구 현황”다음 연구와 공급업체 정보가 이 글의 시점에 따라 달라질 수 있는 주장의 주요 근거입니다.
- Parnas, D. L. (1972): On the Criteria To Be Used in Decomposing Systems into Modules. Communications of the ACM 15(12), 1053–1058. DOI: 10.1145/361598.361623.
- Le Hai, N.; Nguyen, D. M.; Bui, N. D. Q. (2025): On the Impacts of Contexts on Repository-Level Code Generation. Findings of NAACL 2025, 1496–1524. DOI: 10.18653/v1/2025.findings-naacl.82.
- Liu, X. et al. (2025): CodexGraph: Bridging Large Language Models and Code Repositories via Code Graph Databases. NAACL 2025, 142–160. DOI: 10.18653/v1/2025.naacl-long.7.
- Wang, P.; Zhang, L.; Liu, F.; Tao, C.; Zhu, Y. (2026): CodeMEM: AST-Guided Adaptive Memory for Repository-Level Iterative Code Generation. Findings of ACL 2026, 16903–16917. DOI: 10.18653/v1/2026.findings-acl.834.
- Wang, Y. et al. (2026): RepoReasoner: Evaluating Repository-Level Code Reasoning Ability of Long-Context Language Models. FSE 2026.
- Qiu, J. et al. (2025): LoCoBench-Agent: An Interactive Benchmark for LLM Agents in Long-Context Software Engineering. arXiv:2511.13998 (Preprint).
- Zhu, J.; Hu, M.; Wu, J. (2026): SWE Context Bench: A Benchmark for Context Learning in Coding. arXiv:2602.08316 (Preprint).
- Zhang, S. et al. (2026): FastContext: Training Efficient Repository Explorer for Coding Agents. arXiv:2606.14066 (Preprint).
- Luk, C. et al. (2026): ContextSniper: AntTrail’s Token-Efficient Code Memory for Repository-Level Program Repair. arXiv:2607.01916 (Preprint).
- Ma, D. et al. (2026): LLM Agents Can See Code Repositories. arXiv:2606.14061 (Preprint).
- Salim, M.; Latendresse, J.; Khatoonabadi, S.; Shihab, E. (2026): Tokenomics: Quantifying Where Tokens Are Used in Agentic Software Engineering. arXiv:2601.14470 (Preprint).
- GitHub (2026): GitHub Copilot is moving to usage-based billing 및 Model multipliers for annual plans on request-based billing (legacy).
- OpenAI(2026년 8월 기준): Codex rate card 및 추가 Codex 사용을 위한 크레딧 관련 문서.
- Anthropic(2026년 8월 기준): Claude Code usage and limits 및 유료 Claude 요금제의 Usage Credits 관련 문서.