내 프론트엔드도 Big Ball of Mud일까?
새 프로젝트에 들어갑니다. 애플리케이션은 돌아갑니다. 폴더, 컴포넌트, 서비스가 있고 아키텍처 다이어그램까지 있을지 모릅니다.
그런데 처음에는 아무것도 이해되지 않습니다.
우선 걱정할 이유는 없습니다. 새 도메인에는 새 용어가 있고 오래된 애플리케이션에는 역사가 있습니다. 큰 코드베이스를 익히려면 시간이 필요합니다. 훌륭하게 구조화된 시스템이라도 첫날부터 어떤 상태가 왜 존재하는지, 도메인 용어가 무슨 뜻인지, 프로세스가 왜 바로 그 다섯 단계로 이루어지는지 알 수는 없습니다.
그래서 더 중요한 것은 처음에 얼마나 이해하느냐보다 이해가 어떻게 발전하느냐입니다.
많이 알수록 시스템이 단순해집니까? 규칙, 경계, 반복되는 패턴을 발견해서, 나중에는 모르는 부분도 어느 정도 믿을 만하게 예상할 수 있습니까?
아니면 여기서는 왜 규칙이 적용되지 않는지, 이 서비스는 왜 예외인지, 저 컴포넌트는 왜 역사적인 이유로 다른 도메인 세 곳에 직접 접근하는지, 왜 하필 이 부분은 이름대로 쓰면 안 되는지만 배웁니까?
어느 순간 불편한 의심이 듭니다.
아키텍처를 배우는 것이 아닙니다. 아키텍처의 예외를 배우고 있습니다.
그래도 자동으로 빅 볼 오브 머드(Big Ball of Mud)라는 뜻은 아닙니다. 나쁜 아키텍처가 모두 Big Ball of Mud는 아닙니다. 큰 컴포넌트 하나, God Service 하나, 자체 라우팅 시스템, 의존성 순환 몇 개만으로는 아닙니다. Angular 기능이 프레임워크의 예정된 메커니즘을 구속력 없는 권고쯤으로 여긴다는 사실도 충분하지 않습니다.
핵심 질문은 이것입니다.
이 시스템에는 실제로 작용하는 질서가 얼마나 남아 있습니까?
Foote와 Yoder는 Big Ball of Mud를 체계적인 계획보다 당장의 필요에 따라 구조가 만들어지고, 알아볼 수 있는 설계보다 즉각적인 필요가 구성을 더 많이 정하는 시스템으로 설명했습니다. 이후 아키텍처 침식 연구도 개별 위반만이 아니라 의도한 아키텍처와 실제로 작용하는 아키텍처가 점점 멀어지는 과정, 그리고 유지보수와 진화에 미치는 결과를 살펴봅니다.
프론트엔드 진단에서도 이 구분이 중요합니다. Big Ball of Mud는 아키텍처 문제가 많은 시스템에 그치지 않습니다. 문제가 국소적 경계를 잃고, 실제로 작동하는 원리로서의 질서가 점점 사라질 때 심각해집니다.
한곳에 있는 작은 신은 아직 Big Ball of Mud가 아닙니다
섹션 제목: “한곳에 있는 작은 신은 아직 Big Ball of Mud가 아닙니다”먼저 반례를 생각해 보겠습니다.
복잡한 계획 기능을 떠올려 보세요. 지도, 여러 계획 상태, 많은 도메인 규칙과 상호작용이 있을 수 있습니다. 중심에는 수년 동안 대단한 크기로 자란 컴포넌트가 있습니다. 주변에는 긴밀하게 협력하는 작은 컴포넌트 열 개쯤이 있습니다.
중앙 컴포넌트가 데이터를 읽고 상태를 보관하며 사용자 상호작용을 조정합니다. 대화상자를 열고 도메인 판단을 하고, 화면을 이동하고, 갱신을 시작합니다. 다른 삶에서는 별도 책임이 되었을지도 모를 일까지 틈틈이 챙깁니다. 의미 있는 레이어 구분은 거의 보이지 않습니다. 프레임워크 메커니즘은 맞는 곳에서만 쓰고 다른 곳에서는 자체적인 길을 찾았습니다.
짧게 말해 작은 신입니다.
나쁜 프론트엔드 아키텍처입니다. 여러 책임을 한데 모으고, 의미 있는 레이어 구분이 사실상 사라졌습니다. 프레젠테이션, 도메인 로직, 오케스트레이션이 한곳에 모입니다. 국소적으로 보면 일종의 God Object이고, 큰 변경마다 불필요하게 어려워집니다.
하지만 더 중요한 관찰이 있습니다. 문제는 도메인 경계에서 끝납니다.
계획 기능의 내부 구조는 나쁘지만 다른 도메인 영역이 그 상태에 마음대로 접근하지는 않습니다. 계획 기능도 자동으로 나머지 시스템의 절반을 알지는 않습니다. 옆에는 경계를 이해할 수 있는 다른 슬라이스들이 있습니다. 청구 기능을 수정한다고 반드시 계획 컴포넌트에 도달하지 않습니다. 사용자 관리에 그 내부 상태 기계를 이해할 필요도 없습니다.
심각하지만 범위가 제한된 문제입니다.
경계가 나뉜 슬라이스 안의 God Object는 아직 Big Ball of Mud가 아닙니다.
더 일반적으로 말하면 이렇습니다.
나쁜 아키텍처는 국소적일 수 있습니다. Big Ball of Mud는 시스템 차원에서 경계가 무너진 상태입니다.
중요한 반증 검사입니다. 그렇지 않으면 충분히 오래된 거의 모든 애플리케이션이 Big Ball of Mud가 됩니다. 유용한 진단을 하려면 어딘가에 나쁜 구조가 있는지보다 시스템이 그 구조의 범위를 아직 제한할 수 있는지를 봐야 합니다.

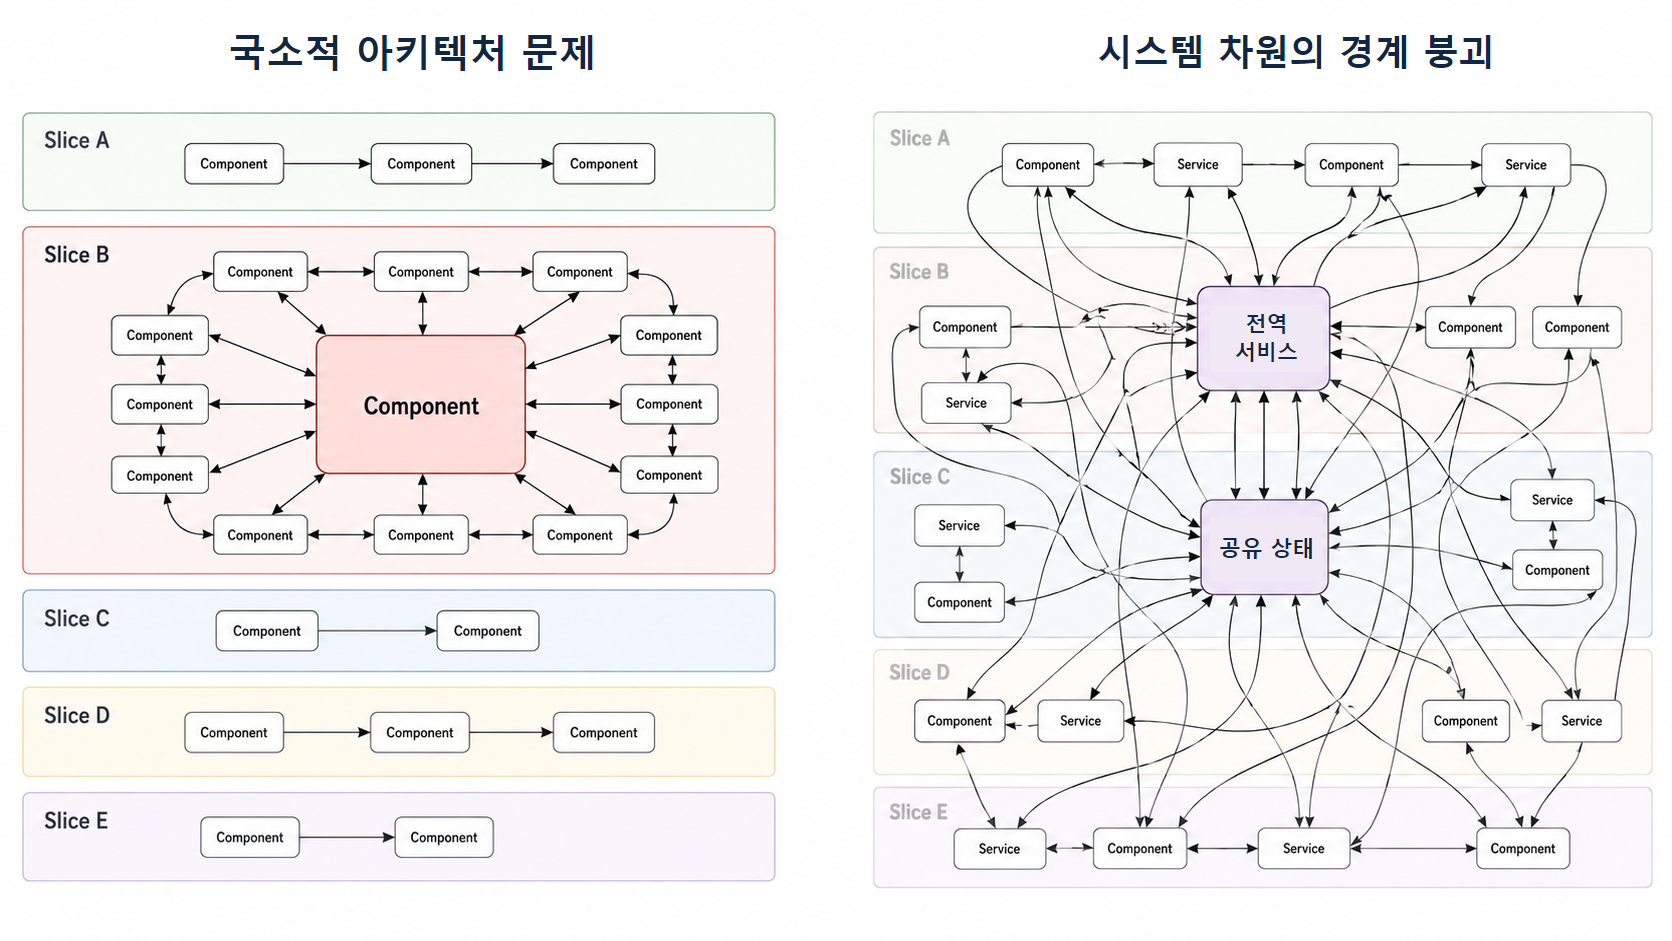
국소적인 God Object는 아직 Big Ball of Mud가 아닙니다. 경계 자체가 제 역할을 잃을 때 심각해집니다.
아무 컴포넌트나 열어 보세요
섹션 제목: “아무 컴포넌트나 열어 보세요”새 프로젝트로 돌아가겠습니다.
애플리케이션을 조금 둘러봅니다. 과학적 조사도, 지표 측정도 아닙니다. 여기서 전형적인 컴포넌트가 어떻게 생겼는지 보고 싶을 뿐입니다.
하나를 엽니다.
위에서부터 의존성 목록이 나옵니다. 사용자 상태, 화면 이동, 권한, 캐시, 대화상자 서비스, 도메인 서비스, 또 다른 도메인 서비스, 전역 상태입니다. 다른 도메인에서 온 것도 있습니다. 처음 보는 이름인데 꽤 중요한 듯한 것도 있습니다.
그 자체로는 거의 증명하지 못합니다. 셸, 복잡한 페이지 컴포넌트, 의도적인 조정 지점에 의존성이 많은 것은 정당할 수 있습니다.
그래서 두 번째 컴포넌트를 엽니다.
세 번째도 엽니다.
어느 순간 우연한 관찰이 패턴이 됩니다.
더 중요한 질문은 이것이 아닙니다.
이 컴포넌트에는 의존성이 몇 개 있습니까?
이 질문입니다.
임의의 컴포넌트 열 개를 열었을 때, 의존성 대부분이 자기 도메인과 예정된 레이어 안에 머뭅니까?
대체로 그렇다면 국소적 예외를 찾았을 가능성이 큽니다. 반대로 거의 아무 컴포넌트나 사용자 상태, 화면 이동, 전역 서비스, 여러 다른 도메인을 안다면 훨씬 흥미롭습니다.
주입 개수 때문이 아닙니다. 국소적 구성 요소가 전 시스템에 대한 지식을 일상적으로 필요로 하는 듯하기 때문입니다.
순진한 이름의 5,000줄짜리 서비스
섹션 제목: “순진한 이름의 5,000줄짜리 서비스”그다음에는 cache.service.ts를 만납니다.
이름부터 안심이 됩니다. 캐시입니다. 아는 개념입니다.
파일을 엽니다.
실제로 캐시를 합니다. 여러 일 중 하나로 말입니다.
사용자 상태도 있습니다. 화면 이동 로직, 약간의 초기화, 여러 도메인 파생 데이터, 상태 변경, 전역 통신도 있습니다. 권한까지 있을지 모릅니다. 일부 메서드는 cache.service.ts에 우연히 들어 있다는 사실이 캐시와의 관련성을 설명하는 주된 근거입니다.
5,000줄 뒤에 적어도 한 가지는 알게 됩니다. 캐시는 수많은 업무 중 하나입니다.
이것도 애플리케이션을 Big Ball of Mud로 만들지는 않습니다. 큰 서비스는 우선 설계 문제입니다. 비교적 독립적으로 나눌 수 있을지도 모릅니다.
더 중요한 것은 **팬인(Fan-in)**입니다. 누가 의존합니까?
서로 독립적인 도메인 영역이 오래된 서비스를 점점 더 많이 사용하면 역할이 달라집니다. 시스템의 중력 중심이 됩니다. 다음 기능도 사용할 만한 이유가 있습니다. 서비스는 이미 있고, 거의 모든 것에 접근하며, 어디에나 주입됩니다.
강화 효과가 생깁니다.
어느 순간 이름은 책임이 아니라 출발점만 설명합니다.
이런 노드는 크기 자체보다 진단적으로 훨씬 흥미롭습니다. 경계가 명확한 소비자가 세 곳인 5,000줄짜리 서비스와 애플리케이션 거의 전체가 구조적으로 의존하는 1,500줄짜리 서비스는 다릅니다.
거의 모든 컴포넌트가 상속하는 기반 클래스
섹션 제목: “거의 모든 컴포넌트가 상속하는 기반 클래스”다른 곳은 놀랄 만큼 정돈되어 보입니다.
많은 컴포넌트가 작습니다. 백 줄, 때로는 그보다 적습니다. 거의 모범적입니다.
그러다 한 줄이 보입니다.
extends BaseComponentBaseComponent를 엽니다.
화면 이동, 사용자 정보, 권한, 로딩 상태, 오류 처리, 캐시, 여러 전역 서비스가 있습니다. 한곳에서만 쓰기에는 너무 유용했던 도메인 보조 함수까지 있을지 모릅니다.
사용처를 검색합니다.
백 곳입니다.
복잡성을 없앤 것이 아닙니다. 어디에나 따라다니는 곳으로 옮겼을 뿐입니다.
물론 상속 자체는 Big Ball of Mud의 징후가 아닙니다. 잘 정의된 기술 기반 클래스는 전적으로 정당할 수 있습니다. 도메인과 기술 경계를 동시에 넘어 시스템의 많은 부분을 암묵적으로 연결할 때 문제가 됩니다.
그러면 국소적인 컴포넌트는 중요한 성질을 잃습니다. 보이는 코드만으로 실제로 무엇에 의존하고 어떤 동작을 가져오는지 더는 신뢰할 만하게 추론할 수 없습니다.
눈에 보이는 구조와 실제로 작용하는 구조가 멀어지기 시작합니다.
첫 사용자 흐름
섹션 제목: “첫 사용자 흐름”어느 순간부터는 파일 하나가 아니라 완전한 흐름을 이해하고 싶어집니다.
단순해 보이는 예를 들겠습니다.
로그인 → 초기화 → 화면 이동 → 첫 도메인 화면.
로그인에서 시작해 인증 서비스로 갑니다. 전역 상태, 초기화 서비스로 이어집니다. Guard와 Interceptor도 등장합니다. 어디선가 사용자를 읽고, 다른 곳에서는 권한을 만듭니다. 화면 이동에는 자체 추상화가 끼어 있습니다. 첫 도메인 화면이 나타날 때까지 두 시간 전에는 존재조차 몰랐던 파일들을 돌아다닙니다.
그러다 어떤 서비스를 바라보며 놀랄 만큼 근본적인 질문을 합니다.
제가 정확히 왜 여기에 와 있죠?
가끔이라면 재미있는 일입니다. 큰 시스템의 실제 흐름은 여러 기술 요소를 거치기 마련입니다.
하지만 반복되는 패턴이라면 아키텍처의 중요한 성질인 **추론의 국소성(Locality of Reasoning)**과 관련됩니다.
여기서는 의도적으로 실용적인 뜻으로 씁니다. 국소적으로 보이는 부분을 의미 있게 추론하려면 동시에 이해해야 하는 맥락이 얼마나 넓은지를 묻는 말입니다.
Parnas도 단지 파일 트리를 예쁘게 하려고 모듈화를 주장하지 않았습니다. 중요한 설계 결정을 모듈 경계 뒤로 숨겨서 시스템의 이해 가능성과 변경 용이성을 개선하는 것도 좋은 분해의 목적이었습니다.
프론트엔드에 적용하면, 작은 도메인 기능을 다룰 때 나머지 시스템의 상당 부분은 그 작업과 관련될 필요가 없어야 합니다.
작은 도메인 질문이 일상적으로 전 시스템의 이해를 요구한다면 의심할 만합니다.
큰 파일 하나보다 훨씬 강한 신호입니다. 이제 스타일이나 코드 품질만의 문제가 아닙니다. 필요한 맥락을 아키텍처가 제한할 수 있느냐의 문제입니다.

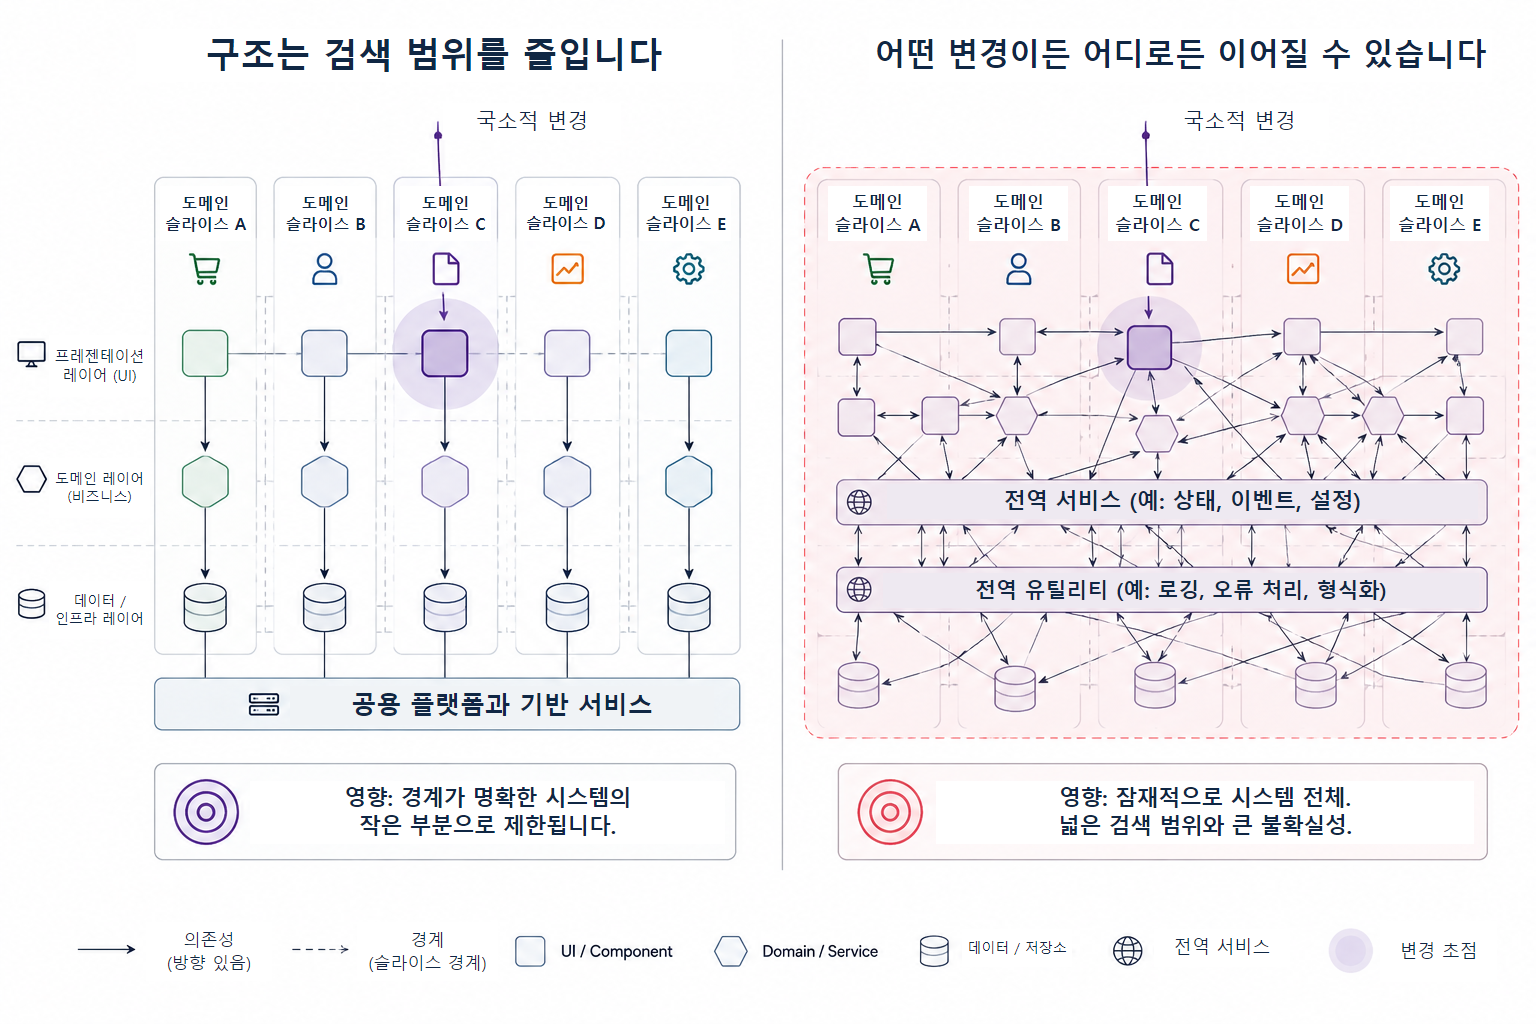
좋은 아키텍처는 파일만 정리하지 않습니다. 변경에 필요한 맥락을 줄입니다.
도메인 경계에 폴더 이름만 남을 때
섹션 제목: “도메인 경계에 폴더 이름만 남을 때”파일 트리만 보면 애플리케이션이 훌륭해 보일 수 있습니다.
customers/orders/planning/schools/billing/users/administration/우선 안심이 됩니다. 도메인 슬라이스가 있습니다.
이제 planning을 수정합니다.
schools에 직접 의존합니다. 도메인 관점에서 이해할 만합니다.
users도 필요합니다. 이것도 이해됩니다.
이어서 administration과 customers가 나옵니다. billing의 공용 서비스도 필요합니다. 다른 곳에서는 schools가 planning을 거꾸로 가져옵니다. users는 다시 customers의 타입을 사용합니다.
연결 하나하나에 그럴듯한 사연이 있을 수도 있습니다.
그래서 진단이 어렵습니다.
도메인 영역은 당연히 서로 소통해야 합니다. 완전한 고립은 현실적이지도, 자동으로 좋은 아키텍처도 아닙니다. 중요한 것은 어떻게 소통하느냐입니다. 정의된 통합 지점이 있습니까? 의존성 방향을 설명할 수 있습니까? 누가 정보를 소유하고 누가 소비하기만 하는지 분명합니까?
아니면 사실상 누구나 누구를 알아도 됩니까?
거의 모든 영역이 마음대로 넘는 도메인 경계는 어느 순간 경계가 아닙니다. 폴더 이름일 뿐입니다.
보이는 아키텍처와 작용하는 아키텍처의 구분이 중요해집니다. 디렉터리에 customers, orders, billing이 보여도 그 영역이 모듈로서 정보를 숨기고, 의존성을 제한하며, 서로의 변경을 차단하는지는 거의 알 수 없습니다.
파일 트리는 점점 바라는 모습을 설명합니다. 의존성 그래프는 코드에서 실제로 어떤 경계가 작용하는지 보여 줍니다.
레이어까지 의미를 잃습니다
섹션 제목: “레이어까지 의미를 잃습니다”같은 일이 두 번째 축에서도 보입니다.
슬라이스의 핵심 질문은 이렇습니다.
도메인에서 누가 무엇을 책임집니까?
레이어의 질문은 다릅니다.
여기에는 어떤 종류의 책임이 있어도 됩니까?
구조화된 프론트엔드의 구체적인 레이어 구분은 다를 수 있습니다. 이름이 반드시 presentation, application, domain, infrastructure여야 하는 것은 아닙니다. 의미를 반복해서 믿을 수 있어야 합니다.
침식되는 시스템은 다릅니다.
컴포넌트가 데이터를 읽고 DTO를 변환하고 도메인 판단을 합니다. 전역 상태를 바꾸고 프로세스를 조정하며 화면을 이동합니다. 그사이에 자기 UI 상태도 보관합니다.
서비스는 대화상자를 열고, 비즈니스 규칙을 담고, HTTP를 처리하고, 캐시를 관리하며, 다음 화면을 정합니다.
인프라가 도메인 결정을 시작합니다. 프레젠테이션이 도메인 상태 전이를 가집니다. 공용 서비스에는 모든 것이 조금씩 있습니다.
컴포넌트 하나에 다른 곳에 두는 편이 나을 규칙이 들어 있다는 것이 문제의 전부는 아닙니다. 실제 애플리케이션에는 거의 모두 그런 위반이 있습니다.
중요한 것은 다음 질문에 쓸 만한 답을 하지 못하는 패턴입니다.
우리 비즈니스 규칙은 어디에 있습니까?
“경우에 따라 다릅니다”는 아직 정상입니다.
“사실상 어디에나 있습니다”라면 더 흥미롭습니다.
비즈니스 규칙이 사실상 어디에나 있을 수 있다면, 레이어 구분은 디렉터리 구조로만 남고 아키텍처로는 사라졌을 수 있습니다.
연구도 아키텍처 침식을 단순히 시각적인 무질서로 보지 않습니다. 구조적 위반, 아키텍처 결정과의 불일치, 유지보수와 진화의 문제를 서로 연결된 양상으로 설명합니다.

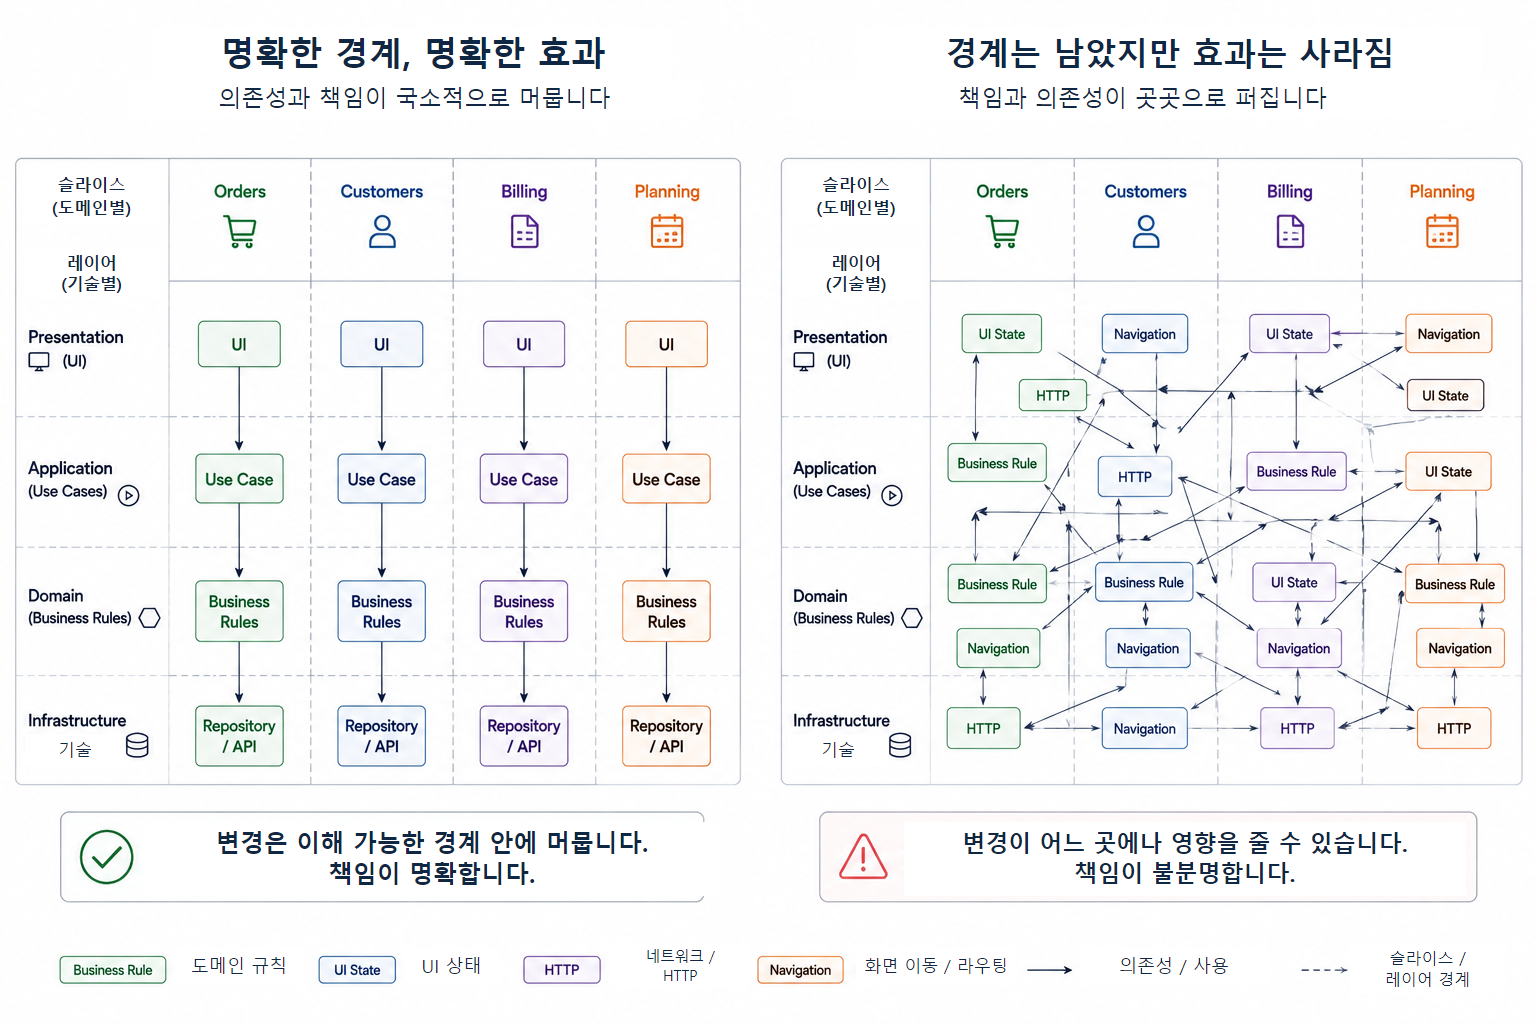
슬라이스가 의존성을, 레이어가 책임을 더는 제한하지 못하면 아키텍처에는 언젠가 이름표만 남습니다.
Router가 아닌 Router
섹션 제목: “Router가 아닌 Router”어느 순간 화면 이동을 이해하고 싶습니다.
Router를 찾습니다.
Router라는 이름의 것을 발견합니다.
시작은 좋습니다.
그런데 실제 화면 이동은 자체 인프라를 통합니다. Route에는 수많은 속성이 있습니다. 뜻이 분명한 것도 있고, 중요해 보이지만 무슨 뜻인지 알 수 없는 것도 있습니다. 권한, 초기화, 어떤 전역 상태의 동작에 영향을 미칩니다.
문서를 찾습니다.
없습니다.
하지만 프로젝트에서 9년째 일하는 사람은 있습니다.
명시적으로 말하겠습니다. 이것은 Big Ball of Mud의 증거가 아닙니다. 프레임워크를 추상화해도 됩니다. Angular Router를 감싸도 됩니다. 요구가 맞는다면 완전히 자체적인 내비게이션 모델을 개발해도 됩니다.
다시 질문은 복잡성의 범위가 제한되고 설명 가능한지입니다.
중앙 인프라가 많은 도메인에 의존하고, 시스템 전체에 부작용이 있으며, 코드와 문서에서 동작을 추론하기 어렵고, 중요한 규칙이 주로 몇 사람의 기억에 있다면, 이전에는 별개였던 문제가 합쳐집니다.
신호는 자체 인프라가 아닙니다.
그 조합입니다.
시스템의 중력 중심
섹션 제목: “시스템의 중력 중심”몇 주 뒤 다른 것도 보입니다.
티켓은 서로 전혀 다릅니다. 사용자 관리, 계획, 권한, 다음 주에는 폼 변경입니다.
그런데 놀랄 만큼 자주 같은 파일 다섯 개에 도달합니다.
전역 Store, 큰 서비스 두 개, 기반 클래스, 아마 정말 도움이 되던 시절에 이름을 얻었을 Helper입니다.
비유하자면 중력 중심입니다. 책임을 끌어당깁니다.
메커니즘은 단순합니다. 중앙 서비스가 사용자, 화면 이동, 권한, 여러 도메인 상태를 이미 안다면 다음 요구를 넣기 아주 편합니다. 필요할 만한 거의 모든 것이 있습니다.
팬인은 더 높아집니다. 그 중심도 시스템의 다른 부분을 더 많이 알아야 하므로 팬아웃(Fan-out)도 커지는 경우가 많습니다.
다음 티켓에서는 결정이 더 쉽습니다.
“전역 서비스에서 처리하죠. 나머지도 거기 있잖아요.”
물리 법칙은 아닙니다. ‘블랙홀’도 당연히 소프트웨어 지표는 아닙니다. 하지만 기존의 중심성이 추가 중앙화를 단기적으로 매력 있게 만드는 실제 강화 효과를 묘사하는 비유입니다.
허브가 자동으로 나쁜 것도 아닙니다. 애플리케이션에는 의도적인 중앙 기술 장치가 필요합니다. 로깅, 텔레메트리, 특정 인프라의 높은 팬인은 정당할 수 있습니다.
중심성이 명확한 책임에서 나오는 것이 아니라 계속 새 외부 책임을 모으면서 생길 때 의심할 만합니다.
어느 순간 의존성 그래프를 그립니다
섹션 제목: “어느 순간 의존성 그래프를 그립니다”여기까지는 경험과 관찰이 많았습니다.
어느 순간 그것으로 부족해집니다.
유독 보기 싫은 곳만 골라 본 것은 아닌지 알고 싶을 수 있습니다. 슬라이스라는 것이 기술적으로 실제 있는지 확인하고 싶을 수도 있습니다. 막연한 느낌에 구조적 근거가 있는지 보고 싶을 수도 있습니다.
그래서 import와 의존성을 분석합니다.
처음의 기대는 단순합니다. 그래프에서 도메인 군집을 알아볼 수 있어야 합니다. 중앙 기술 컴포넌트 몇 개와 원하지 않는 교차 연결 몇 개는 있을 수 있습니다. 그래도 아키텍처 다이어그램의 구조를 대체로 찾을 수 있어야 합니다.
때로는 정확히 그렇습니다.
때로는 다른 일이 벌어집니다.
슬라이스를 가로지르는 의존성이 셀 수 없이 나옵니다. 화살표는 양방향입니다. 팬인이 극도로 높은 노드가 시스템의 넓은 부분을 잇습니다. 거대한 팬아웃을 가진 노드도 있습니다. 독립적이라던 영역 사이에 순환이 생깁니다. 여러 순환이 큰 **강연결 요소(Strongly Connected Component, SCC)**로 이어집니다.
방향 그래프에서 강연결 요소는 방향을 따른 경로로 서로 도달할 수 있는 노드들을 묶습니다. 소프트웨어 의존성에서 큰 SCC가 뜻하는 핵심은, 그 안의 부분을 해당 수준에서 깔끔한 비순환 방향으로 정렬할 수 없다는 것입니다. 그래서 의존성 순환 분석 연구와 도구는 SCC를 유용한 구조적 단위로 사용합니다. 자동적인 Big Ball of Mud 진단으로 쓰는 것은 아닙니다.
순환 하나로 Big Ball of Mud가 되지는 않습니다.
열 개도 자동으로 그렇지는 않습니다.
시스템의 상당 부분이 큰 순환 구조에 속하고, 순환이 슬라이스 경계를 넘으며, 같은 노드가 동시에 전역 중력 중심으로 나타날 때 흥미로워집니다.
Sangal, Jordan, Sinha, Jackson은 이미 2005년에 정적으로 추출한 의존성으로 대형 소프트웨어의 실제 구조를 드러내고 명시적 아키텍처 규칙에 맞춰 검사하는 방법을 보여 줬습니다. 모델의 진단적 가치는 여기에 있습니다. 다이어그램 자체가 아키텍처는 아니지만, 다이어그램에서 주장하는 경계가 코드에 아직 존재하는지 보여 줄 수 있습니다.
가중치를 반영한 의존성 선들이 어두운 덩어리로 합쳐지면 ‘Big Ball of Mud’라는 이름은 적어도 시각적으로 놀랄 만큼 그럴듯해집니다.
다만 말장난입니다. 역사적으로 이름이 그렇게 붙은 이유는 아닙니다.
변경이 도메인상 알맞은 곳에 머뭅니까?
섹션 제목: “변경이 도메인상 알맞은 곳에 머뭅니까?”의존성 그래프는 정적 구조를 보여 줍니다. 평범한 개발 과정에서는 두 번째 관점이 생깁니다.
티켓을 받습니다.
“Planning에 검증 추가.”
국소적으로 들립니다.
계획 기능을 수정합니다. 이어 전역 서비스를 고쳐야 합니다. 공용 기반 클래스도 바꿉니다. 두 번째 도메인 영역도 같은 상태를 간접적으로 쓴다는 사실이 드러납니다. 전역 메커니즘의 부작용을 정확히 모르므로 안전을 위해 다른 흐름 세 개도 테스트합니다.
그럴 수 있습니다. 도메인 요구가 티켓보다 넓을 때도 있습니다.
그래서 여기서도 반복이 중요합니다.
도메인 요구의 변경 범위와 기술적 변경 범위가 얼마나 잘 일치합니까?
국소적 도메인 요구를 보통 기술적으로도 국소적으로 구현할 수 있다면 경계는 제 역할을 합니다.
반대로 작은 도메인 변경을 일상적으로 멀리 떨어진 많은 부분에 나눠 구현해야 한다면 시스템은 **변경의 국소성(Locality of Change)**을 잃습니다.
도메인 변경 범위와 기술적 변경 범위가 덜 일치할수록 진단상 더 흥미롭습니다.
정적 import에만 의존할 필요는 없습니다. Gall, Hajek, Jazayeri는 이미 1990년대 말에 논리적 결합 또는 진화적 결합을 연구했습니다. 모듈이 구조적으로 분리되어 보여도 이력에서는 거듭 함께 바뀔 수 있습니다. 모듈·하위 시스템 경계를 넘어 반복되는 동시 변경은 숨은 의존성과 문제 있는 분해를 가리킬 수 있습니다.
Big Ball of Mud에서는 특히 흥미롭습니다. 의존성 그래프에서 orders와 customers가 비교적 나뉘어 보여도, 여러 해 동안 한쪽의 변경이 다른 쪽의 변경을 반복해서 요구했다면 버전 이력은 다른 이야기를 더합니다.
아키텍처는 코드를 어떻게 배치했는지에만 나타나지 않습니다.
어떻게 변경할 수 있는지에도 나타납니다.
대체 누가 소유합니까?
섹션 제목: “대체 누가 소유합니까?”기술 구조를 살펴보다 보면 놀랄 만큼 단순한 질문이 나옵니다.
누가 책임집니까?
계획 슬라이스는요?
전역 상태는요?
캐시 서비스는요?
기반 클래스는요?
화면 이동은요?
다섯 곳에 구현된 핵심 도메인 규칙은요?
답은 여러 가지입니다.
“어떻게 보면 모두의 것입니다.”
“역사적으로 그렇게 됐습니다.”
“X에게 물어봐야 합니다.”
“사실 아무도 없습니다.”
또는 늘 나오는 말입니다.
“아무도 손대지 않는 편이 좋습니다.”
오너십은 조직도만의 문제가 아닙니다. 팀이 공식적으로 모듈을 맡지 않아도 구조로 오너십을 표현할 수 있습니다.
도메인 규칙을 찾을 때 어느 영역이 소유해야 하는지 이해할 수 있습니까?
상태를 바꿀 때 그 결정을 통제하는 위치가 보입니까?
모듈이 인터페이스를 제공할 때 외부에 무엇을 약속하고 무엇은 내부 사정인지 분명합니까?
경계가 크게 무너진 시스템에서는 코드만 흩어지지 않습니다. 책임도 흐려집니다.
문제는 더 커집니다. 누가 결정을 소유하는지 정확히 말할 수 없으면 경계를 일관되게 지키기 어렵습니다.
아키텍처 침식 연구도 원인이 기술에만 있지 않음을 보여 줍니다. 기술 위반과 함께 조직 요인, 지식, 개발 관행, 장기적인 아키텍처 관리가 중요합니다.
아키텍처는 시스템을 더 예측 가능하게 해야 합니다
섹션 제목: “아키텍처는 시스템을 더 예측 가능하게 해야 합니다”여기서 한 걸음 물러나 볼 만합니다.
왜 슬라이스, 레이어, 의존성 방향, 오너십에 관심을 가집니까?
아키텍처 다이어그램이 예뻐서가 아닙니다.
아키텍처는 가능한 해법과 검색의 범위를 줄입니다.
어느 영역의 도메인 규칙이 그 Domain에 있다는 것을 알면 아무 컴포넌트, HTTP 서비스, 공용 Helper에서 찾을 필요가 없습니다.
billing이 planning에 직접 의존하면 안 된다는 것을 알면 특정 경로를 제외할 수 있습니다.
프레젠테이션이 정의된 Application 인터페이스로만 슬라이스와 소통한다면 UI를 변경할 때 그 인프라 전체를 이해할 필요가 없습니다.
그래서 좋은 구조는 시간이 지나며 예측 가능성을 만듭니다.
모르는 영역을 열어도 무엇이 나올지 대략 압니다.
코드는 몰라도 규칙은 압니다.
그래서 온보딩 경험은 진단적으로 흥미롭습니다. 복잡해도 구조가 좋은 시스템은 처음에 압도적일 수 있습니다. 하지만 알아갈수록 머릿속 모델은 압축되어야 합니다. 수많은 개별 관찰을 소수의 안정된 규칙으로 설명할 수 있어야 합니다.
Big Ball of Mud에서는 학습 곡선이 반대로 갈 수 있습니다.
점점 더 많이 압니다.
하지만 그 지식으로 추론할 수 있는 것은 점점 줄어듭니다.
느낌에서 진단으로
섹션 제목: “느낌에서 진단으로”새 프로젝트 첫 주부터 아키텍처 포렌식을 시작하는 사람은 거의 없습니다.
작은 의문으로 시작하는 편입니다.
“왜 저것에 의존할까요?”
그다음입니다.
“제가 왜 이 파일에 와 있죠?”
나중에는 이렇습니다.
“왜 모두 이 서비스를 알죠?”
어느 순간 이렇게 됩니다.
“왜 여기서는 누구나 누구를 알죠?”
느낌은 유용한 출발점입니다. 충분한 결과는 아닙니다.
그래서 여러 관점을 함께 볼 필요가 있습니다.
- 눈에 보이는 의존성
- 실제 변경 패턴
- 슬라이스 경계
- 레이어 경계
- 중력 중심
- 이해해야 하는 범위
- 변경 범위
- 오너십
그중 여러 가지가 같은 이야기를 해야 작은 의문이 구조적 의심이 됩니다.

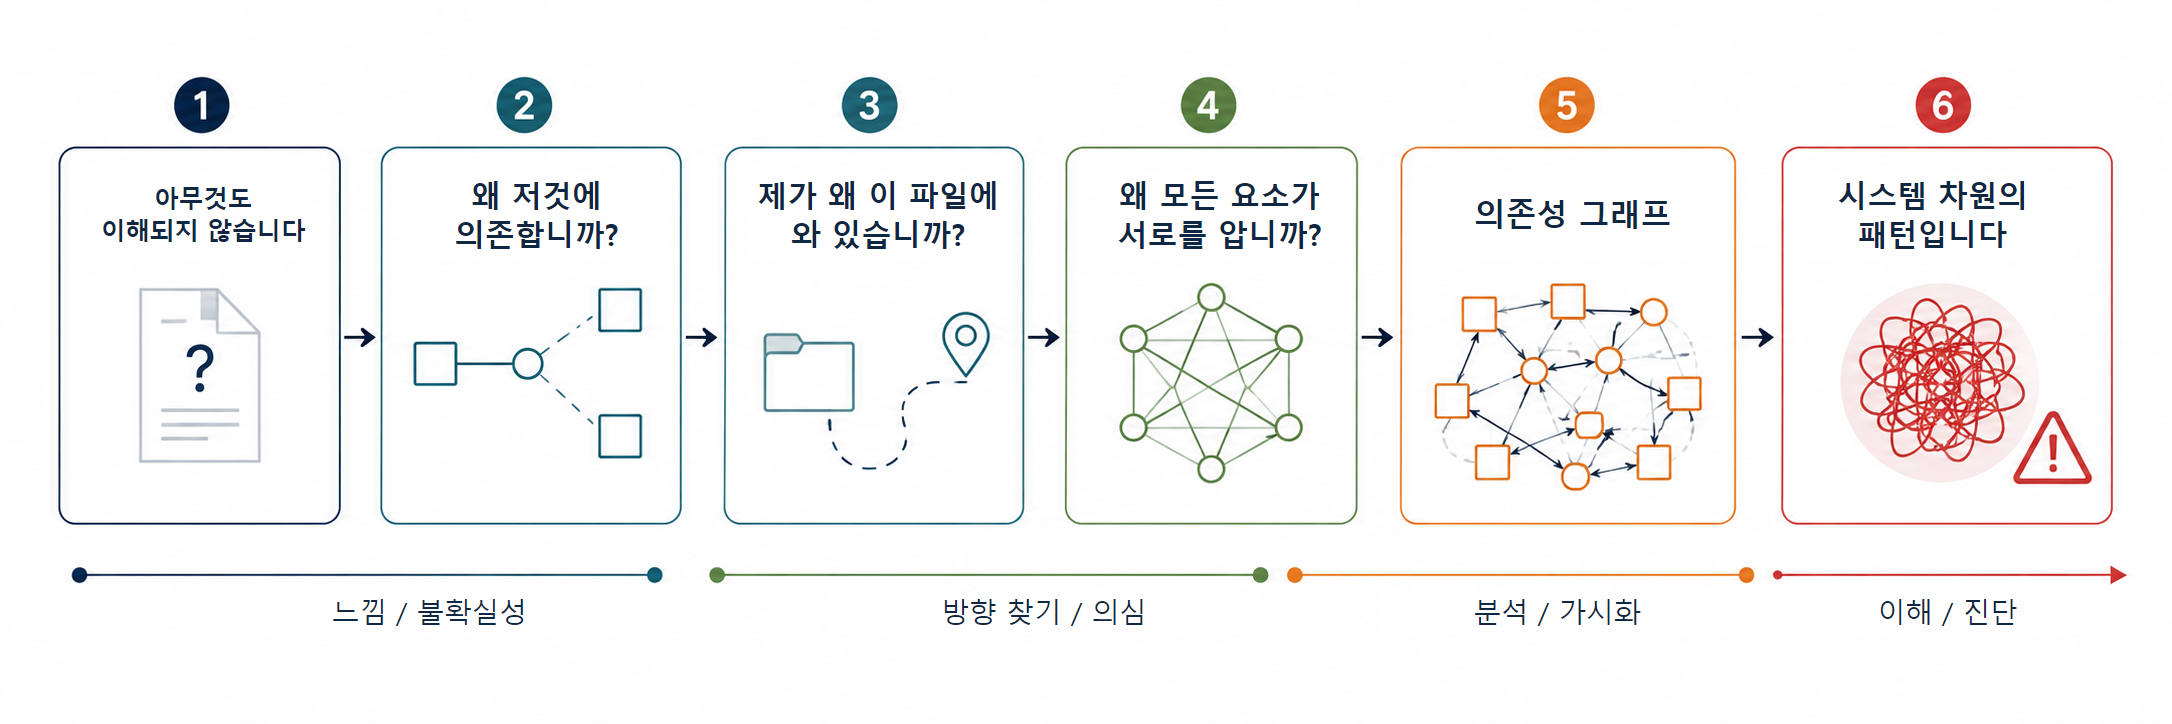
의심은 느낌에서 시작하는 경우가 많습니다. 진단은 느낌에서 끝나서는 안 됩니다.
모든 증상의 무게가 같지는 않습니다
섹션 제목: “모든 증상의 무게가 같지는 않습니다”그러면 불편한 질문이 남습니다. 실제로 강한 징후는 무엇입니까?
과학적으로 검증된 Big Ball of Mud 척도는 없습니다. 아래의 가중은 의도적으로 아키텍처 휴리스틱입니다. 진단 임계값이 아닙니다.
약하거나 국소적인 징후
섹션 제목: “약하거나 국소적인 징후”이 관찰들은 단독으로는 놀랄 만큼 적은 것만 말해 줍니다.
- 매우 큰 컴포넌트
- God Service
- 문제 있는 기반 클래스
- 고립된 기능 안의 레이어 부재
- 개별 의존성 순환
- 오래된 프레임워크 패턴
- 자체 인프라
- 이해하기 어려운 도메인
모두 상당한 아키텍처 문제일 수 있습니다. 하지만 핵심은 문제에 아직 경계가 있느냐입니다.
처음의 계획 기능은 구조가 형편없어도 작동하는 도메인 슬라이스 안에 있을 수 있습니다. 전역 기술 서비스도 중심성이 높으면서 단 하나의 정확한 책임을 수행할 수 있습니다.
훨씬 강한 징후
섹션 제목: “훨씬 강한 징후”같은 문제가 반복해서 경계를 넘으면 더 흥미롭습니다.
- 여러 도메인 슬라이스에서 같은 패턴이 나타납니다.
- 컴포넌트가 체계적으로 여러 다른 도메인에 접근합니다.
- 비즈니스 규칙이 사실상 어디에나 있을 수 있습니다.
- 중앙 서비스가 애플리케이션의 큰 부분에서 사용되며 서로 다른 책임을 모읍니다.
- 슬라이스 간 의존성에 알아볼 수 있는 방향이 거의 없습니다.
- 작은 변경에도 일상적으로 멀리 떨어진 영역의 지식이 필요합니다.
- 아키텍처 규칙에 정착된 예외가 너무 많아 예측력이 약합니다.
- 아키텍처 다이어그램과 실제 의존성이 다른 이야기를 합니다.
진단의 초점이 국소적 설계 문제에서 시스템 전체 구조로 옮겨갑니다.
매우 강한 징후
섹션 제목: “매우 강한 징후”몇 가지 기본 질서 장치가 동시에 실패하면 특히 심각합니다.
- 애플리케이션의 큰 부분이 공동 의존성 순환이나 SCC에 속합니다.
- 도메인 경계가 기술적으로 거의 작동하지 않습니다.
- 레이어에 믿을 만한 의미가 없습니다.
- 핵심 영역의 오너십을 조직적으로도 구조적으로도 타당하게 정하기 어렵습니다.
- 작은 변경이 일상적으로 예상 밖의 시스템 전체 영향을 일으킵니다.
- 새 개발자가 점점 더 많은 예외를 배워도 안정된 머릿속 모델을 만들지 못합니다.
- 여러 효과가 동시에 나타나 서로를 강화합니다.
중요한 것은 상호작용입니다.
큰 SCC 하나는 Big Ball of Mud의 수학적 정의가 아닙니다. 높은 팬인도, 높은 변경 빈도도, 레이어 위반 열 개도 아닙니다.
그래서 이런 규칙은 신뢰할 수 없습니다.
증상이 다섯 개 이상이면 Big Ball of Mud입니다.
Big Ball of Mud는 측정값 하나가 아니라 시스템의 상태입니다.
제가 실제 진단에서 찾는 것
섹션 제목: “제가 실제 진단에서 찾는 것”오늘 모르는 프론트엔드를 조사한다면 어떤 나쁜 패턴이 있는지부터 묻지 않겠습니다.
그런 것은 거의 언제나 찾을 수 있습니다.
가장 중요한 구조적 제한이 아직 작동하는지 알아보겠습니다.
도메인 슬라이스가 의존성을 제한합니까? 완전히 고립시키지는 않더라도 통합 지점과 방향을 이해할 만큼은 제한합니까?
레이어가 책임을 제한합니까? 비즈니스 규칙, UI 상태, 오케스트레이션, 인프라가 어디에 있는지 어느 정도 믿고 예상할 수 있습니까?
의존성에 알아볼 수 있는 방향이 있습니까? 아니면 서로 의존하는 거대한 영역이 생깁니까?
추론이 국소적으로 머뭅니까? 작은 도메인 흐름을 설명하려면 애플리케이션을 얼마나 이해해야 합니까?
변경이 국소적으로 머뭅니까? 국소적 티켓 때문에 도메인상 멀리 떨어진 부분으로 얼마나 자주 가야 합니까?
중앙 구성 요소는 책임이 중앙에 있기 때문에 중앙에 있습니까? 아니면 오래된 편의의 집합소일 뿐입니까?
오너십을 알아볼 수 있습니까? 누가 결정을 소유하고 어떤 부분은 소비하기만 하는지 이해할 수 있습니까?
마지막 질문입니다.
눈에 보이는 아키텍처가 실제 소프트웨어를 아직 설명합니까?
어쩌면 가장 중요한 질문입니다.
아키텍처가 있으려면 완벽해야 하는 것은 아닙니다. 레거시가 있어도 됩니다. 보기 싫은 기능, 임시 해법, 오래된 타협, 기술 부채가 있어도 됩니다.
경계에 의미가 남아 있는 한 추론의 기반이 있습니다.
Big Ball of Mud는 믿고 제외할 수 있는 가능성이 점점 줄어드는 지점에서 시작합니다.
모든 책임이 어디에나 있을 수 있습니다.
모든 영역이 다른 모든 영역에 의존할 수 있습니다.
모든 변경이 뜻밖에 다른 어딘가에 영향을 줄 수 있습니다.
모든 규칙에는 먼저 이런 말을 붙여야 합니다.
“물론 이 경우는 빼고요…”
Big Ball of Mud가 있습니까?
섹션 제목: “Big Ball of Mud가 있습니까?”자기 프로젝트와 닮은 부분을 불편할 만큼 많이 발견했을지 모릅니다. 그래도 개별 증상만으로 Big Ball of Mud라고 진단할 수는 없습니다. 관찰들을 조금 더 체계적으로 비교하고 싶다면 작은 아키텍처 자가 점검이 있습니다.
Big Ball of Mud가 있습니까? → (독일어 도구)
시간이 지나면 더 이해하기 쉬워집니까?
섹션 제목: “시간이 지나면 더 이해하기 쉬워집니까?”마지막에는 프로젝트의 첫날로 돌아옵니다.
큰 시스템에 들어와 처음에는 아무것도 이해되지 않습니다.
정상입니다.
구조가 있는 복잡한 시스템에서는 시간이 지나며 달라집니다. 도메인을 배우고 책임을 알아봅니다. 경계와 의존성 방향을 이해합니다. 수많은 파일이 서서히 모델이 됩니다.
그 모델은 새로운 부분을 더 예측 가능하게 합니다.
아직 모르는 컴포넌트라도 어떤 일을 맡아도 될지 압니다. 한 번도 바꾸지 않은 슬라이스라도 도메인 규칙이 어디에 있어야 할지 가늠합니다. 의존성을 보면 왜 그 방향이 타당한지 설명할 수 있습니다.
지식은 늘지만 필요한 정신적 맥락은 줄어듭니다.
Big Ball of Mud에서는 반대일 수 있습니다.
몇 달 뒤에는 엄청난 세부사항을 압니다. 메서드 A를 B보다 먼저 호출해야 한다는 것, 전역 캐시의 세 예외, 어떤 화면 이동을 절대 직접 시작하면 안 되는 이유를 압니다. BaseComponent가 왜 특정 도메인 상태를 갖는지 설명할 사람도 압니다.
첫날보다 많이 압니다.
하지만 믿을 만한 모델은 만들어지지 않습니다.
그래서 Big Ball of Mud를 알아보는 기준은 5,000줄짜리 파일 하나, 프레임워크를 이상하게 쓰는 개발자, 구조가 나쁜 기능 하나가 아닙니다. 그런 문제는 심각해도 알아볼 수 있는 경계를 가진 경우가 많습니다.
경계 자체가 사라질 때 시스템은 의심스러워집니다.
프론트엔드의 Big Ball of Mud는 특히 여러 종류의 구조적 경계 붕괴가 함께 작용하면서 드러납니다. 도메인 슬라이스가 의존성을 제한하지 못하고, 레이어가 책임을 제한하지 못합니다. 변경은 국소적으로 머물지 못합니다. 중앙 구성 요소는 남의 책임을 점점 더 모읍니다. 의존성의 방향은 사라지고 오너십을 정하기도 점점 어려워집니다.
이제 진짜 문제는 나쁜 컴포넌트, God Service, 잘못된 import 하나가 아닙니다.
아키텍처가 믿고 제외해 주는 가능성이 점점 줄어드는 것입니다.
몇 달 뒤 시스템을 아주 많이 알면서도 책임이 어디서 시작하고 끝나며 누구를 알아도 되는지 믿을 만하게 설명하지 못한다면, 아마 단순한 온보딩 문제만은 아닐 것입니다.
출처와 더 읽을 문헌
섹션 제목: “출처와 더 읽을 문헌”- Brian Foote, Joseph W. Yoder: Big Ball of Mud. Technical Report WUCS-97-34, 1997; 이후 Neil Harrison, Brian Foote, Hans Rohnert(편)의 Pattern Languages of Program Design 4 제29장에 수록되었습니다. Addison-Wesley, 2000.
- Ruiyin Li, Peng Liang, Mohamed Soliman, Paris Avgeriou: Understanding Software Architecture Erosion: A Systematic Mapping Study. Journal of Software: Evolution and Process 34(3), 2022, e2423. DOI:
10.1002/smr.2423. - Ruiyin Li, Peng Liang, Mohamed Soliman, Paris Avgeriou: Understanding Architecture Erosion: The Practitioners’ Perceptive. Proceedings of the 29th IEEE/ACM International Conference on Program Comprehension (ICPC), 2021, S. 24–35. DOI:
10.1109/ICPC52881.2021.00037. - David L. Parnas: On the Criteria To Be Used in Decomposing Systems into Modules. Communications of the ACM 15(12), 1972, S. 1053–1058. DOI:
10.1145/361598.361623. - Harald Gall, Karin Hajek, Mehdi Jazayeri: Detection of Logical Coupling Based on Product Release History. Proceedings of the International Conference on Software Maintenance (ICSM), 1998, S. 190–197. DOI:
10.1109/ICSM.1998.738508. - Neeraj Sangal, Ev Jordan, Vineet Sinha, Daniel Jackson: Using Dependency Models to Manage Complex Software Architecture. OOPSLA 2005, S. 167–176. DOI:
10.1145/1094811.1094824.