生成很便宜,验证很昂贵
过去几个月里,我在使用 Coding Agents 工作时越来越明显地感受到一个现象:代码本身,出人意料地经常已经不再是问题所在。
过去可能要预留半天的实现,如今条件合适时几分钟就能完成。Agent 分析相关代码,修改多个文件,补单元测试,运行构建和代码检查,交付一个技术上看似合理的补丁。
这依然令人印象深刻。但工作并不会因此自动结束。
我仍须理解改了什么,判断业务需求是否满足,检查方案是否符合既有架构,是延续原有概念,还是悄悄造了第二套。有的改动,还要关注安全、契约、迁移、运行行为或性能。
于是出现一种奇怪的不对称:如果实现只要五分钟,认真审查却仍需专注二十、三十甚至六十分钟,会怎样?
多个 Agent 并行时,这种效应更加明显。
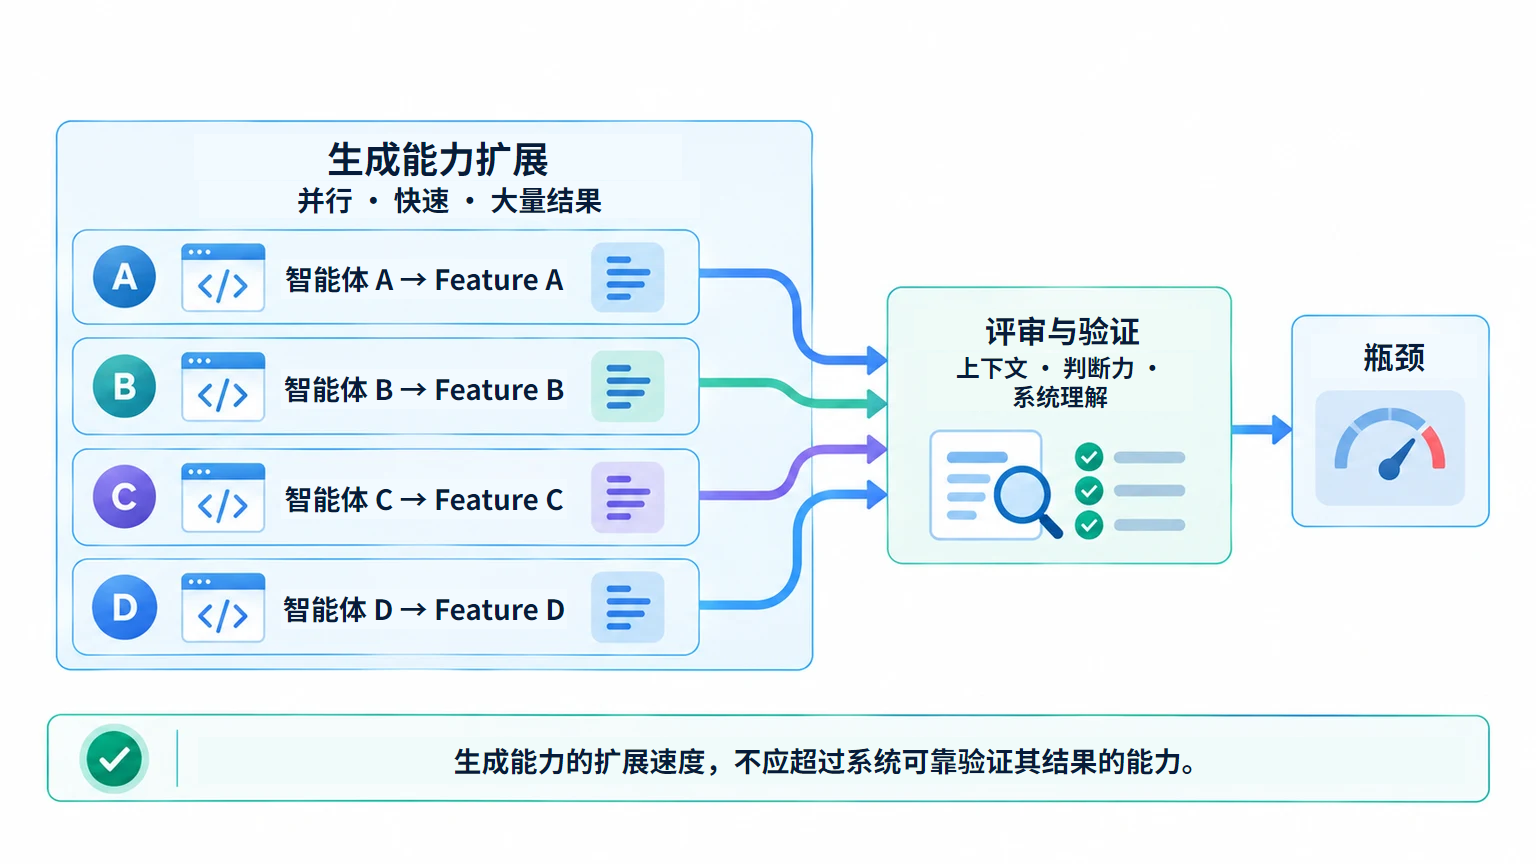
这还不是成本核算。下一篇文章我才会讨论那一层问题。这里我更关心另一个问题:
当代码生成变得又便宜又快时,“验证”到底意味着什么?
随着吞吐量上升,变化的不只是我们生产软件的方式。真正困难的部分也在移动。
生成能力的扩张,比信任的建立更快。
一个补丁,就是一项主张
Section titled “一个补丁,就是一项主张”本系列第 6 篇已经讨论过一个相关问题:看起来合理,并不等于真实。模型完全可能非常有说服力地犯错。这里我不想重复那层讨论,而是再往前走一步。
Coding Agent 生成补丁时,实际上隐含着一项广泛的主张:
这项改动满足需求,适配已有系统,不违反相关约束,也不引入不可接受的副作用。
补丁本身没有证明这一点。它就是这项主张。
验证必须提供足够的证据,让我们愿意接受这项主张。
这听起来比日常工程更抽象,但实际上并不是。我们早就在使用各种各样的证据渠道。真正的问题,是不要把这些渠道各自能说明什么混在一起。
| 信号 | 实际回答的问题 |
|---|---|
| 构建 | 被检查代码能否在给定条件下构建? |
| 类型检查 | 类型系统捕获的静态假设是否一致? |
| 代码检查 | 改动是否遵守明确编码的规则? |
| 单元测试 | 限定单元是否在所述场景中按预期行为? |
| 集成测试 | 多个相关部分能否在被测场景中协同? |
| E2E / 验收测试 | 具体流程能否跨多个系统边界正常运行? |
| 架构规则 | 是否遵守明确建模的结构边界? |
| 人的审查 | 方案在给定业务和技术上下文中是否合理? |
| 架构审查 | 职责、概念和依赖是否仍符合系统模型? |
这些检查没有任何一个是没价值的。恰恰相反:好的软件工程,很大程度上依赖于把尽可能多的重要属性变成可机械验证的东西。只是它们各自能证明的范围有限。
构建通过不能证明业务正确,单元测试不能证明业务规则位于正确层次。E2E 可以保障完整用户流程,却仍可能看不到:为了这条流程,我们已在已有机制旁引入第二套状态概念。
一次检查通过,只能为它实际检查过的内容提供证据。
因此,核心问题不再是有没有测试,而是:
对于这项具体改动,我们到底需要什么证据?
为此,我使用一个工程模型概念:验证面(Verification Surface)。
一项改动的验证面,是它所触及、因而需要合理检查的相关业务、技术、结构和运行属性的集合。
关键在于:这个“面”并不等于 Diff 的大小。
机械式改动可以涉及 500 行:也许只是按已有模式调整 Mapper、移动文件,或修改定义明确的 DTO 转换。补丁很大,有意义的自由度却很少。编译器、测试和少量针对性检查,可能已覆盖大部分相关错误类别。
而十行代码的改动,可能完全不同。
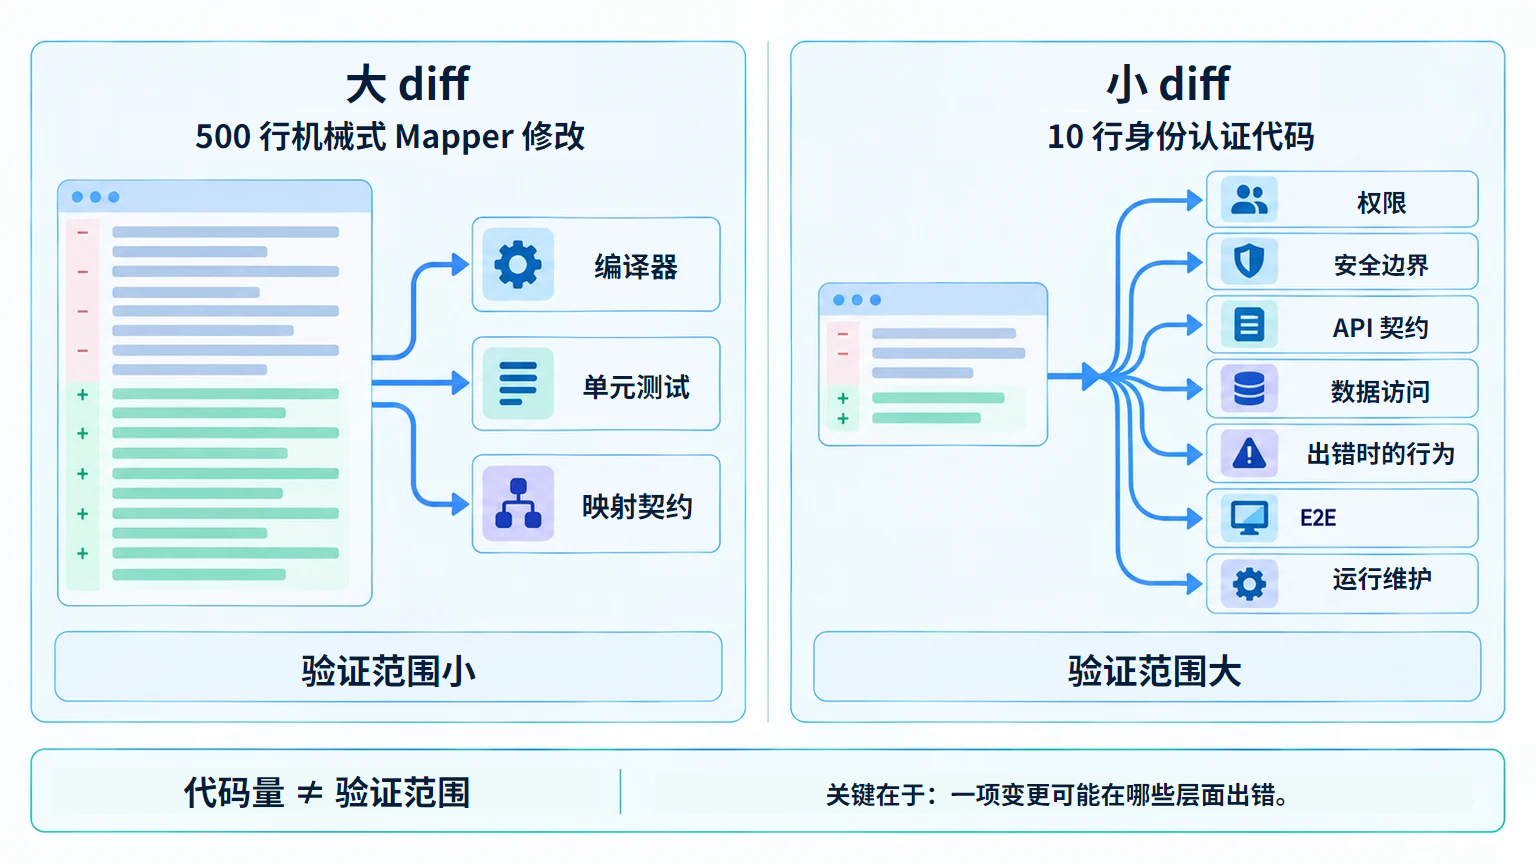
改动很小。
验证面却很大。
核心状态机制、权限判断、Schema 变更,以及公开契约上的小调整,也可能如此。
代码量与验证面,不是一回事。
当代码生产越来越便宜时,写了多少行代码会进一步失去解释力。更有意思的问题变成:这项改动可能在哪些层面出错?
这也避免了另一种偏差:检查深度不应条件反射地随改动行数增加。小文本修正不需要架构审查,小权限规则改动却可能需要。
局部正确,系统性错误
Section titled “局部正确,系统性错误”最近一次经历,让我非常直观地看到了这两个概念的区别。
某个系统的 +state 已有一个常规 Signal Store,角色经过有意识设计。相关业务状态、响应式派生值、数据流和状态变化,都遵循既定模型。
后来,Agent 又在 application 层创建了一个自制 Store。
两个 Store 不自动构成架构错误。Source Store 与独立的 ViewModel Store,可以有完全合理的不同职责。如果任务不同,划分有意识地建模,这甚至可能更好。
但这里不是这种情况。
第二个 Store 没有独立业务职责。它把已有派生值再次转换,开始重复建模状态职责。同时,还把 computed、effect 等响应式机制与明显更命令式的风格混在一起。
于是出现两种漂移。
第一种是职责漂移(Responsibility Drift):职责转移或重复,却没有新业务概念支撑。
第二种是范式漂移(Paradigm Drift):同一问题空间中,开始出现第二套编程与状态模型。
局部看,代码并不荒谬,可以运行,测试也可以通过。
恰恰因此,这次改动值得注意。此前约十项任务,Agent 一直做得很干净,我的注意力也随之下降。有一次没有看得那么深入,系统里就突然多出一套状态概念。
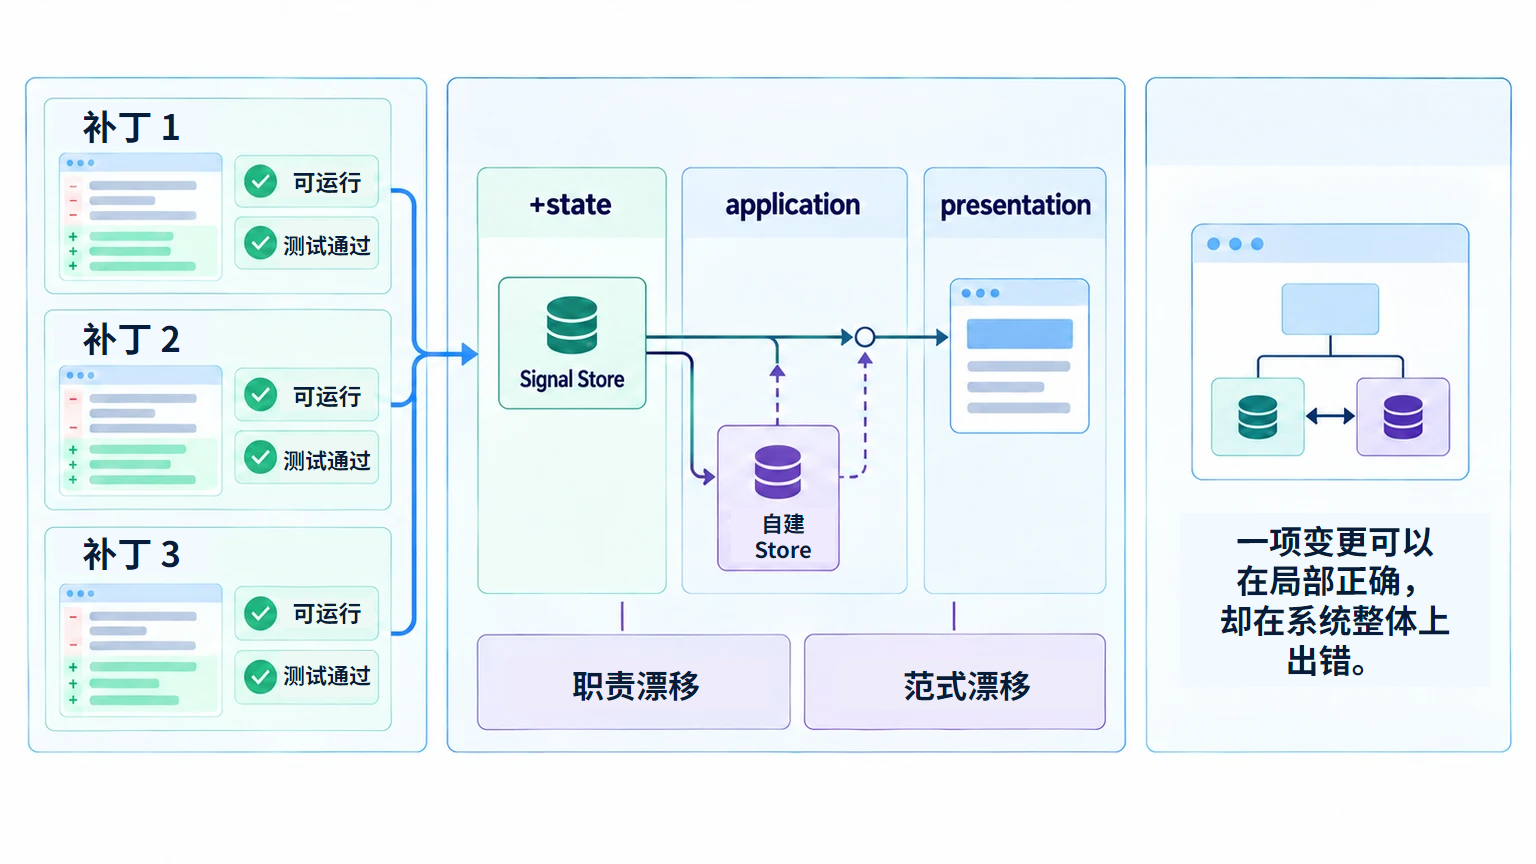
一项改动可以在局部是正确的,却在系统层面是错误的。
架构漂移往往并非一个明显错误的决定,而是一连串局部合理的决定,逐渐把系统带向另一方向。
可靠的历史会改变注意力
Section titled “可靠的历史会改变注意力”这个例子里还有第二个机制,对我同样重要。
Agent 连续十次可靠地工作,我会从中学习。这很合理,信任本就来自经验。与人协作也一样:多年交付好结果的人,与改动中常有根本问题的人,受到的审查自然不同。
但信任也有副作用。成功的历史会改变我的注意力深度。
这并不是说人会因此变懒或变得粗心。它只是说明:我们的注意力是有限的,而我们会根据概率去分配它。一个长期表现稳定的系统,看上去就不那么需要深度检查。
在自动化生成场景中,这会变成一个特别的问题,因为生产速率同时还在上升。
过去可靠,不能证明下一个补丁也可靠。
好的历史记录是预期工作流可靠性的证据,不能代替具体改动的验证。
这里开始出现一种后文要讨论的债务:验证债务(Verification Debt)。
架构审查,本质上是验证职责
Section titled “架构审查,本质上是验证职责”我的架构会有意识地让各层保持“无聊”。这一点对 application 尤其如此。
通常,我不希望 application 出现意料外的业务逻辑。它聚合相关 Store 属性或用例,向表现层提供清晰契约。已属于状态职责的业务规则,不应再在这一层出现。
其他方向也一样。业务规则不因表现层刚好收到某个事件,就该塞进表现层。UI 职责不因 Store 里某个 Signal 方便,就迁入 Store。基础设施映射不属于状态。新状态抽象需要可识别的职责,不能仅因技术上做得到就存在。
因此,架构审查回答的问题,与行为测试不同。
测试可以检查行为。架构审查检查职责是否还在正确位置。
所以,我不会把架构审查简化为模式匹配。
模式有用,分层规则有用,导入约束尤其适合自动化。例如,可以阻止 presentation 直接访问 infrastructure。
难题有时是:这个新抽象为何存在?它有独立职责,还是把同一职责又建模一遍?
回答这种问题,审查者需要系统模型。
今天,我仍认为这种系统理解是经验丰富开发者的价值所在。但我不会把它定义为人与机器永久的边界。审查模型和上下文检索在改善,架构知识也越来越能显式提供给模型。
更谨慎的说法是:
今天,系统级审查往往比局部改动审查需要更多、更稳定的上下文。
规则很有帮助——只是它们不知道未来所有偏差
Section titled “规则很有帮助——只是它们不知道未来所有偏差”Store 的例子之所以有意思,还因为这个环境绝不是毫无治理的。
我现在使用分层规则、Agent Files、Skills、专门审查指令和自动检查。上一篇正讨论了这个发展:构建、代码检查、测试和 E2E 逐渐成为智能体基础设施,让 Agent 能执行并检查自己的改动。
第二个 Store 抽象,依然出现了。
这不否定上一篇,而是说明显式规则擅长减少已知的漂移类别。
非法导入可以由架构规则阻止,错误依赖可以被约束拒绝,缺少测试可以在 CI 中暴露,命名违规可以由代码检查发现,错误的层间访问可以被自动限制。
更难的是还没有规则覆盖的偏离:第二套竞争概念、新隐式职责、多余抽象、范式混用,或一个技术上可用、却重复实现了其他库中已有机制的方案。
架构规则得事先知道这个问题,才能精确禁止。
显式规则能减少已知漂移类别,不能预见所有新的、局部合理的偏离。
所以,我仍认为应让更多架构规则可执行,但架构审查不会因此变简单。规则审查越来越容易自动化,系统审查目前仍更难。
审查者,不该先被说服
Section titled “审查者,不该先被说服”还有一点改变了我使用审查 Agent 的方式:我尽量不让它一开始就接受实现 Agent 的辩护。
原因其实非常“人类”:修辞会形成锚定。
口才好的开发者,可以把可疑的技术决策讲得很有说服力。我有过这样的经历。多年前,与一位专业知识丰富、表达很强的同事讨论微服务,长谈之后,我几乎相信这个概念根本行不通。
后来有一次骑自行车时,我突然想到:
等等。刚才那套说法其实根本站不住脚。
并不是因为那位同事什么都不懂。恰恰相反。正是因为他的专业能力很强,那套论证才更容易让人信服。
这件事一直留在我的记忆里。一段很好的解释,会在我真正独立检查对象本身之前,就先影响我的判断。
AI 生成代码也一样。实现之后,Coding Agent 可以漂亮地解释,为何方案优雅、如何延续已有模式、如何满足所有需求。
这是一条有用的信息。
但它不是证明这件事真实的证据。
看起来合理的理由,不是证据。
因此,我更愿意给审查 Agent 另一种任务。不是解释编码 Agent 的方案是否合理,而是:
Requirement+Constraints+相关系统 Context+Diff↓独立验证实现理由以后仍可能有用。我只是不希望它先决定验证者的主要观察角度。
验证者(Verifier)应对照需求与约束检查方案,而非对照生成者(Generator)的解释。
独立证据,需要不同视角
Section titled “独立证据,需要不同视角”这引出另一个概念:独立证据(Independent Evidence)。
很容易把独立性等同于模型数量:Agent A 实现,Agent B 审查,于是好像已有两个视角。
但这并不会自动成立。
我经历过一个真实工作流:一位初级开发者借助 Agent 实现,另一位借助 Agent 审查。结果很好看,审查 Agent 没发现实质问题。
接着,一位有经验的审查者只问了一个关键问题。
整个方案开始崩塌。
随后,一个有意配置得更强的审查 Agent,找出了多项严重问题。
这不是说初级开发者不该用 AI,或第二个模型没有价值。值得注意的是:
多了第二个模型,不代表审查就具有独立性。
两个模型可以继承同样假设,找不到同一片仓库区域,漏掉同一架构规则,读取同一份不完整需求上下文,接受同一个貌似合理的说法。
因此,独立性更多来自验证视角,而不是模型身份本身。
生成者问:怎样实现这条需求?
验证者更应问:这个补丁可能违反哪条相关需求、约束或系统假设?
这仍然不能保证真正独立。但至少两边的任务已经不是同一个。
能够反驳,本身就是一种能力
Section titled “能够反驳,本身就是一种能力”现在,我会明确期待强模型反驳我。
我不需要审查者告诉我,我的想法其实很好。如果错了,我希望尽早知道。
与前沿模型的长时间技术讨论中,这已多次发生。我起初观点明确,模型在某处反对,我们讨论底层假设,最后我改变了看法。
我不觉得工作流失败了。
这正是工作流。
我需要的审查者,不是只确认方案看似合理,而是在有可靠理由时提出反对。
这不意味着每次审查都要做成最强烈的红队对抗。
我也试过。如果命令 Agent 无论如何都找风险,它就会找。到后来,理论边界情况与真实架构违规被同等追究。下一轮修复增加保护逻辑、回退和抽象,又成为下轮审查的新攻击目标。
这有时会让软件更稳健。
也可能让软件变得过度防御、难以阅读。
所以,对我来说更好的特性不是最大攻击性,而是校准(Calibration):有充分理由时就反驳;现有证据已经足够时,也应该接受方案。
独立证据引出一个相关原则:不同检查渠道,最好别只重复同一个问题。
我称之为验证多样性(Verification Diversity)。
贴近实现的单元测试,与 E2E 对错误的敏感性不同。架构规则能发现的问题,与业务审查者不同。静态类型检查与安全审查发现的缺陷也不同。审查 LLM 可能发现测试从未描述的异味,业务负责人也可能发现,技术完美的实现做错了需求。
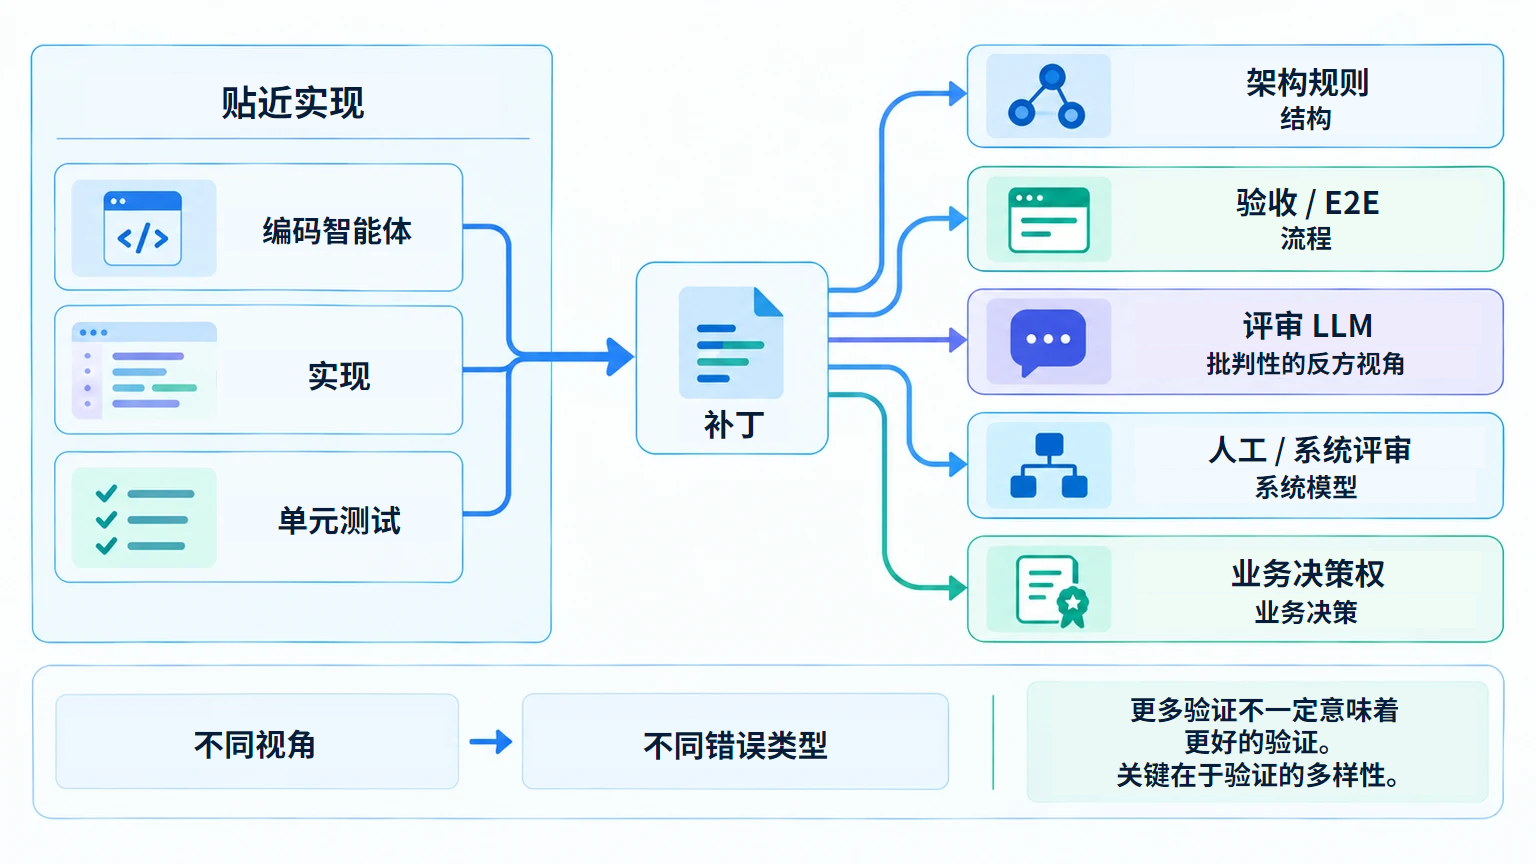
目的不是给每个补丁堆尽可能多的检查者。
更多验证,并不会自动变成更好的验证。关键在于,不同渠道是否能暴露不同且相关的错误类别。
因此,检查深度也应由验证面决定。静态文本改动的验证面很小。功能同时涉及表现层、应用层、状态、基础设施和 API,验证面就大。我会关注分层边界、切片、自治、已有模式、不必要的新依赖,以及是否复用已有工具,还是另造一套。
改动行数,至多是多个信号之一。
验证面更多取决于触及哪些边界,而非改了多少行。
不同测试层级,需要不同程度的独立性
Section titled “不同测试层级,需要不同程度的独立性”独立证据的要求,不该变成新教条。
例如,我不赞成一概禁止实现 Agent 写自己的单元测试。单元测试常用来保障具体实现,在这个场景下,靠近实现未必有问题。
实现业务函数的 Agent,可以补充直接相关的单元测试,覆盖边界情况,保障局部不变量。这些测试属于补丁的一部分,为具体实现增加证据。
验收或 E2E 测试,我则倾向于更强的独立性。
那里更重要的不是单个方法能否工作,而是预期流程能否跨相关层正常运行。因此,我更倾向让有需求和系统访问能力的专门 Agent,从另一视角检查完整流程。
但不能夸大证明力。E2E 只能检查明确描述的预期行为,现实需求却很少完整。
测试只能对照足够明确的预期验证。测试更多,不会自动补全缺失需求。
这是验证本身的重要边界。证据只能将主张与已知或可推导的预期对照。没人知道特殊情况应怎样表现,测试就不可能凭空做出业务决定。
好的 Verifier 知道自己权限的边界
Section titled “好的 Verifier 知道自己权限的边界”因此,验证还包括一个问题:究竟谁有权决定?
业务需求不清楚,应由业务方决定。架构师或开发者可以解释选项、技术后果和不一致,但不自动有权发明业务规则。
反过来,架构决策也不因源于业务工单,就自动属于业务方。
我的工作中,这道边界相对清楚:业务方拥有业务决策权,工程与架构方拥有技术决策权。
最近在更强的模型上,我越来越常看到一种我非常希望出现的行为:模型发现某个地方不清楚,然后直接说,这个问题必须和业务负责人确认。
这是一个好答案。
第 10 篇文章已经用“停下来,别猜”讨论过这种态度。放到验证中,它意味着:
好的验证者,不必回答每个问题,但必须知道何时自己无权回答。
对我来说,这还意味着另一条信任边界:有权实现功能,不等于自动有权批准改变验证标准。Agent 可以编写测试,也可以提出规则修改。但改变验收条件、检查规则或必需检查的选择,需要有意识地审查。如果它引入原本禁止的依赖,再放宽 Lint 规则,绿色结果就不能证明原有标准得到了满足。
检查结果只适用于实际检查的内容和相关检查条件,例如测试、规则、配置和环境。Hash 标识一个状态,既不能证明运行确实执行过,也不能证明检查质量。成功报告因此不自动等同于可核查的运行输出和产物。这是一条工程上的边界,并不是声称这里已经证实了某个安全漏洞。
有意识的例外,还是未察觉的漂移?
Section titled “有意识的例外,还是未察觉的漂移?”架构规则也不是自然法则。
偏离规则有时合理。遗留契约也许阻碍理想架构,技术限制也许使既定模式不可行,完整方案也许能做,却不符合具体产品的经济条件。
但我不会接受一句:“没办法,只能这样。”
如果真的要打破一条规则,那么规则本身就应该重新成为分析对象。它为什么在这里不适用?有哪些替代方案?是否已经有成熟做法?这个偏差能否被限制在局部?长期意味着什么?
有时分析之后,答案确实仍然是:我们接受这个例外。
那我希望有意识地做决定。如果经济现实迫使我们接受技术上较差的方案,那就是技术债务。关键是知道自己承担了它。
有意识的例外,是决策。未察觉的例外,是架构漂移。
这不是在主张每个小问题都写一份官僚式 ADR。它只是主张:真正重要的偏差,不应该悄无声息地消失在“普通实现细节”里。
这样就可以更精确地定义前面的概念。
我说的验证债务,不只是缺少测试。
当与接受改动相关的必要检查被推迟,并产生额外不确定性、后续风险或未来工作,就形成了验证债务。
并非每个未检查的草稿都是债务。不承诺采用、可以丢弃的探索方案,不必全做验证;数量受控、尚待检查的改动,也不自动是验证债务。后续工作已依赖未经充分检查的改动时,推迟必要检查尤其危险,且可能在部署前发生。持续生成超过适当检查能力的待接受改动,仍是吞吐量问题。
多个 Agent 并行时,可能如此;实现时间剧降、审查时间却未按相同比例缩短时,可能如此;构建、代码检查和单元测试自动化很好,系统性改动却只浅看时,也可能如此;审查 Agent 只看局部改动,而竞争抽象在其上下文之外,也一样。
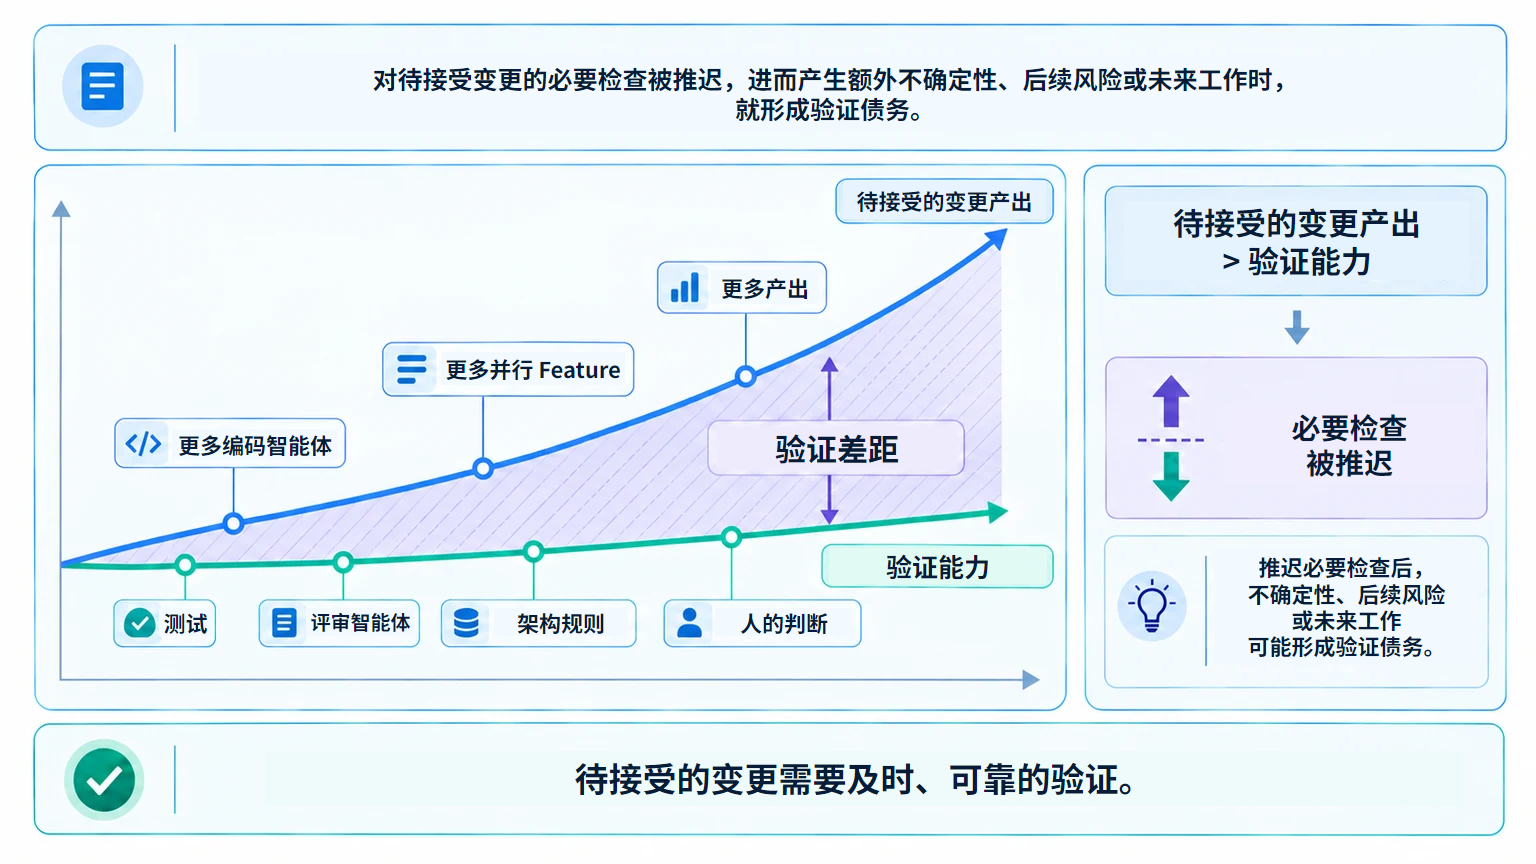
有一项限制很重要:智能体工作不自动制造验证债务。
如果验证能力随生成能力按比例增长,就不一定产生债务。这才是工程工作要解决的问题。
不能只扩大生成能力,也必须扩大检查、理解和可靠接受结果的能力。
生成,更容易并行化
Section titled “生成,更容易并行化”目前,我不断碰到一个非常实际的边界。
我可以同时启动多个 Coding Agent:一个实现功能,一个重构,第三个补测试,第四个写文档。
单从计算上推演,几乎可以不断设想更高的吞吐量。但我的注意力没法以同样方式并行。
如果两项改动的业务和架构上下文不同,我就不能同时认真理解两者。我能来回切换,委托审查,自动化机械检查。
但系统性判断,目前仍是有限资源。
因此,我个人现在最常遇到的瓶颈,已经出人意料地不再是写代码。
认真审查,目前才是瓶颈。
这里“目前”两个字非常重要。
审查模型和仓库检索在进步,架构规则更明确,模型获得更大、更稳定的工作空间。也许几年后,今天我亲自检查的很大一部分,可以可靠自动化。
所以,更普遍的论点根本不需要建立在人类与 AI 永久对立的边界上:
瓶颈会移动到那些“信任还无法被充分自动化”的地方。
这也为并行化划出了一条边界:
生成能力的扩张,不该超过系统可靠验证其产出的能力。
软件开发,真的正在转向验证工作吗?
Section titled “软件开发,真的正在转向验证工作吗?”我自己的这项观察,已经和当前研究中的一部分结果出现了相当明显的呼应。但现有证据还远远不足以把它直接推广成所有软件团队的普遍规律。
Annie Vella 与 Kelly Blincoe 在 2026 年的一项纵向研究值得关注。她们间隔六个月调查专业软件工程师,首轮 158 人,次轮 101 人,95 人有配对纵向数据。82% 表示实际写代码的时间减少。作者描述了从 creation(创造)向 verification(验证)的广泛迁移,提出 supervisory engineering work(监督式工程工作),指引导、评估、纠正 AI 产出。同时,感知到的生产力提升仍很高;但配对样本中,至少一项开发者体验变差的比例,从 14% 升至 27%。截至 2026 年 9 月,这仍是预印本或已投稿稿件,需谨慎解读。
Agnia Sergeyuk、Ilya Zakharov、Ekaterina Koshchenko 与 Maliheh Izadi 的系统性综述更广,综合了开发环境中人机协作体验的 90 项实证研究。它既发现生产力收益,也发现额外验证开销和过度依赖。质量风险反复涉及正确性、可维护性和安全。研究已发表于 Empirical Software Engineering,也表明该领域高度异质,仍缺乏长期、贴近现实的评估。
Mohamed、Assi 与 Guizani 对 39 项同行评审研究的系统性综述和映射研究,也给出谨慎图景:多数报告生产力收益,尤其在例行任务和代码搜索中;代码质量却没有一致效果,高度依赖任务、测量方法和情境。
研究确实支持工作内容在迁移,却不支持“验证工作更多,生产力必定更低”的简单等式。
产出更多,也可能只是转移了工作
Section titled “产出更多,也可能只是转移了工作”Feiyang Xu 等人在 2025 年的研究考察了引入 GitHub Copilot 后的开源项目。经验较少或较外围的贡献者,生产力提升更明显,返工也增加。分析中,经验丰富的核心开发者审查了多 6.5% 的代码,自己的代码生产力却下降 19%。这应视为会议论文或预印本:它提示局部收益可能在系统内部转移工作,不是 AI 辅助开发的通用效应值。
定性数据从另一角度显示了可能的摩擦。Sebastian Baltes、Marc Cheong 与 Christoph Treude 在 2026 年预印本中,分析了 Reddit 与 Hacker News 关于 AI Slop 的 1,154 条讨论。一个核心编码主题是审查摩擦(Review Friction):额外审查负担、信任损失和应对措施。这反映选定在线社区的感知与讨论,不是代表性团队的生产力实测。
Fawzy、Tahir 与 Blincoe 的 2026 年预印本,通过 162 位参与者比较非开发者、新手与专业开发者的验证实践。作者描述了 perception-action gap(认知与行动差距):普遍知道 AI 代码可能有问题,但评估、调试、验证能力,随经验和实际编程实践而有更大差异。这不证明只有资深开发者能验证 AI 代码,只支持一个谨慎结论:风险意识和验证能力,是不同能力。
反向证据同样重要
Section titled “反向证据同样重要”只挑这些研究,很容易讲出预设的故事:AI 生成更多代码,经验丰富的开发者不停修,最终所有人都吃亏。
研究没有这么简单。
Microsoft、Accenture 与另一家 Fortune 100 公司的随机实地实验,共涉及 4,867 名开发者。Cui 等人的合并分析报告,有权使用生成式编码助手的开发者完成任务约多 26%;经验较少者采用率更高,生产力收益更大。该工作于 2026 年发表于 Management Science,表明现实企业中,AI 辅助可以对被测吞吐量有正向总体效果。
著名的 METR 2025 实验则指向另一方向。16 名资深开源开发者,在熟悉多年的仓库中完成 246 项真实任务。使用当时的 AI 工具,平均用时增加 19%。感知差距尤其有意思:他们以为自己更快了。部分额外时间花在提示和审查生成结果上。
但这 19% 也不能被冻结成永恒结论。
METR 于 2026 年 2 月发布了后续模型世代的数据,更偏向可能加速。但选择效应和并行 Agent 的时间测量困难,使它不足以给出新的可靠效应值。研究者因此调整了研究设计。
对我来说,科学上更有意思的是:任务类型、经验、代码库、模型世代、工具、质量标准、验证基础设施和工作流,都会改变结果。
目前最合理的总结,反而更加克制:
证据越来越多地表明,部分开发工作正从创造转向引导、审查和验证。最终是净生产力收益,还是额外负担,高度依赖具体情境。
为什么系统理解,今天仍有价值
Section titled “为什么系统理解,今天仍有价值”这又把我带回第二个 Store。
有经验的开发者,更容易识别这个实现的问题,未必因为十行代码读得更快。优势在别处。
他往往有一个系统模型。
他知道已有 Store,知道其职责,能看出新抽象没有建模独立业务概念。也可能发现,另三项局部改动各自合理,合起来却在建立新的架构范式。
这种知识,会改变“经验”的价值所在。
今天,理解系统的开发者,价值越来越不在更快写补丁,而在看见许多补丁合起来怎样改变系统。
这里“今天”依然很重要。
没有技术定律规定,AI 永远不能拥有足够好的系统模型。上下文良好时,审查 Agent 已经很强,能发现错误层间访问、破坏的契约、缺失测试、可疑错误处理和不一致实现。
难题是:抽象能工作,但同一概念是否已在另一个 Slice 中?长期是否会形成两套竞争状态模型?
Agent 必须先找出可比较的已有机制,理解语义关系,再判断相似性是有意隔离,还是不必要的重复。
这比局部改动审查,验证面大得多。
审查自动化,取决于证据能否获取
Section titled “审查自动化,取决于证据能否获取”我仍不会因此断言“AI 只能做表层审查”。
相反,我喜欢用专门审查 Agent,对照需求、架构规则和改动检查。尤其在约束明确时,它们能承担大量机械式审查。
真正关键的是另一点:
相关证据和上下文能被审查者获取多少,审查自动化才能扩展多少。
这也衔接上一篇《为什么好的软件也是 AI 友好的软件》。
上一篇问:Agent 能否自己运行构建、代码检查、测试与 E2E?
这一篇问:通过的结果到底证明什么?哪些质量维度仍未回答?
可执行工作空间,是有力验证的重要基础,却不定义具体改动要验证到什么程度才够。那取决于验证面。
“昂贵”,首先是指注意力
Section titled ““昂贵”,首先是指注意力”这篇文章的标题是:
Generation is cheap, verification is expensive.
这里的 expensive,我暂时还不是主要指欧元、美元或 Token。
验证需要注意力、判断和相关上下文,有时需要独立模型运行、真实运行环境、安全专业知识,或不该由 Agent 独自做出的业务决定。
生成可以几分钟拿出四个貌似合理的方案,哪个可以接受的问题,却不会消失。
也许将来,这个判断也会更多自动化。这是合理的延续。但只要生成扩张快于可靠验证,瓶颈就只是在移动。
实践结论很明确:Coding Agent 的并行程度,不能超过验证系统能处理的吞吐量。我们至少应像投资 Coding Agent 一样,有意识地投资审查 Agent、验收测试、架构规则和其他验证基础设施。对于系统验证面大的改动,今天我仍会有意让真正理解系统的人参与。
最后这一点是否永远必须由人完成,仍然是开放问题。背后的原则更普遍。
生成越便宜,越要认真问:接受一项改动,到底需要什么证据?
因此,不只该衡量 Agent 生成多少代码,还要理解生成补丁如何成为经过验证、可以接受的改动。
因为从这里马上会出现下一个问题。
如果验证需要注意力、模型运行、测试、E2E、真实基础设施和人的判断,一项值得充分信任的改动,究竟花费多少?
这就是经济层面的视角。
而它属于下一篇文章。
代码会更便宜。信任不会自动更便宜。瓶颈会移到信任仍无法充分自动化的地方。
来源与研究定位
Section titled “来源与研究定位”Annie Vella, Kelly Blincoe — “The Impact of AI Coding Assistants on Software Engineering: A Longitudinal Study”, 2026.
针对专业开发者的纵向混合方法研究,两次测量间隔六个月。与从创造向验证的迁移及 supervisory engineering work 概念相关。截至 2026 年 9 月,应视为预印本或已投稿稿件。
Agnia Sergeyuk, Ilya Zakharov, Ekaterina Koshchenko, Maliheh Izadi — “Human-AI experience in integrated development environments: a systematic literature review”.
综合 90 项研究的系统性综述,发表于 Empirical Software Engineering。涉及生产力收益、额外验证开销、过度依赖,以及正确性、可维护性和安全风险。它也表明研究高度异质,呼吁更长期、更广泛的评估。
Amr Mohamed, Maram Assi, Mariam Guizani — “The Impact of LLM-Assistants on Software Developer Productivity: A Systematic Review and Mapping Study”.
综合 39 项同行评审研究。多数报告生产力收益,代码质量结果却不一致,且高度依赖情境。
Feiyang Xu, Poonacha K. Medappa, Murat M. Tunç, Martijn Vroegindeweij, Jan C. Fransoo — “AI-assisted Programming May Decrease the Productivity of Experienced Developers by Increasing Maintenance Burden” / “GenAI as a coding partner”.
分析引入 Copilot 后的开源开发,报告了核心开发者更多的审查和返工。应视为会议论文或预印本。它提示工作可能转移,不是通用效应值。
Sebastian Baltes, Marc Cheong, Christoph Treude — “An Endless Stream of AI Slop: How Developers Discuss the Burden of AI-Assisted Software Development”, 2026.
对 1,154 条 Reddit 与 Hacker News 讨论的定性分析,涉及感知到的审查摩擦、信任损失和维护负担。它反映开发者讨论,不应当作代表性生产力测量。
Ahmed Fawzy, Amjed Tahir, Kelly Blincoe — “From Prompting to Verification: How Experience Shapes Vibe Coding Practices”, 2026.
包含 162 位不同经验水平参与者的问卷预印本。涉及 perception-action gap:风险意识与实际验证 AI 软件的能力,不是一回事。
Kevin Zheyuan Cui, Mert Demirer, Sonia Jaffe, Leon Musolff, Sida Peng, Tobias Salz — “The Effects of Generative AI on High-Skilled Work: Evidence from Three Field Experiments with Software Developers”. Management Science,2026 年 2 月 27 日在线发表。出版信息与 DOI。
Microsoft、Accenture 与一家 Fortune 100 公司的随机实地实验,共 4,867 名开发者。合并分析报告明显生产力收益,是反对“一概增加负担”叙事的重要反向证据。
Joel Becker, Nate Rush, Elizabeth Barnes, David Rein / METR — “Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity”.
随机实验,涉及 16 名资深开源开发者,在熟悉仓库中完成 246 项真实任务。使用 2025 年初的工具,平均用时增加 19%。METR 明确提醒不要泛化;2026 年后续数据提示效应可能变化,尚不足以给出新的精确效应值。
本文将验证面(Verification Surface)、验证债务(Verification Debt) 和验证多样性(Verification Diversity) 用作工程模型。引用研究没有确立这套具体术语,只提供与额外验证开销、工作内容迁移、审查负担和情境相关生产力有关的实证联系。