AI 正在加速我们走向“大泥球”——一个假设
一切往往从一个无害的 subscribe() 开始
Section titled “一切往往从一个无害的 subscribe() 开始”过去十年,我作为顾问接触过不少 Angular 应用。有一种场景反复出现:组件里有很长的 subscribe() 回调,其中塞满条件判断、状态赋值、通知、路由跳转,甚至完整的业务流程。
我不认为开发者一开始就想在订阅回调里造出一套小型状态管理系统。最初的需求很可能非常简单:
loadItem(id: string): void { this.api.loadItem(id).subscribe(item => { this.item = item; });}请求返回后,把结果赋给一个属性。结束。这本身并没有错。subscribe() 并不天然是反模式,Angular 也从未禁止命令式代码。
三周后,加载结果满足某些条件时需要显示警告。接着,某些结果又需要触发路由跳转。再后来,其他组件也要用这些数据,于是这个方法开始填充缓存。慢慢地,它就可能变成这样:
loadItem(id: string): void { this.api.loadItem(id).subscribe(item => { this.item = item; if (item.warning) this.notifications.warn(item.warning); if (item.status === 'archived') this.router.navigate(['/archive']); this.cache.set(id, item); });}这个简化例子还算不上 Big Ball of Mud。但它揭示了一种演变方向:原本只负责接收数据的订阅回调,逐渐承担起彼此无关的职责。下一条需求到来时,开发者面对的不再是清晰的设计,而是一个“似乎什么都能做”的方法。

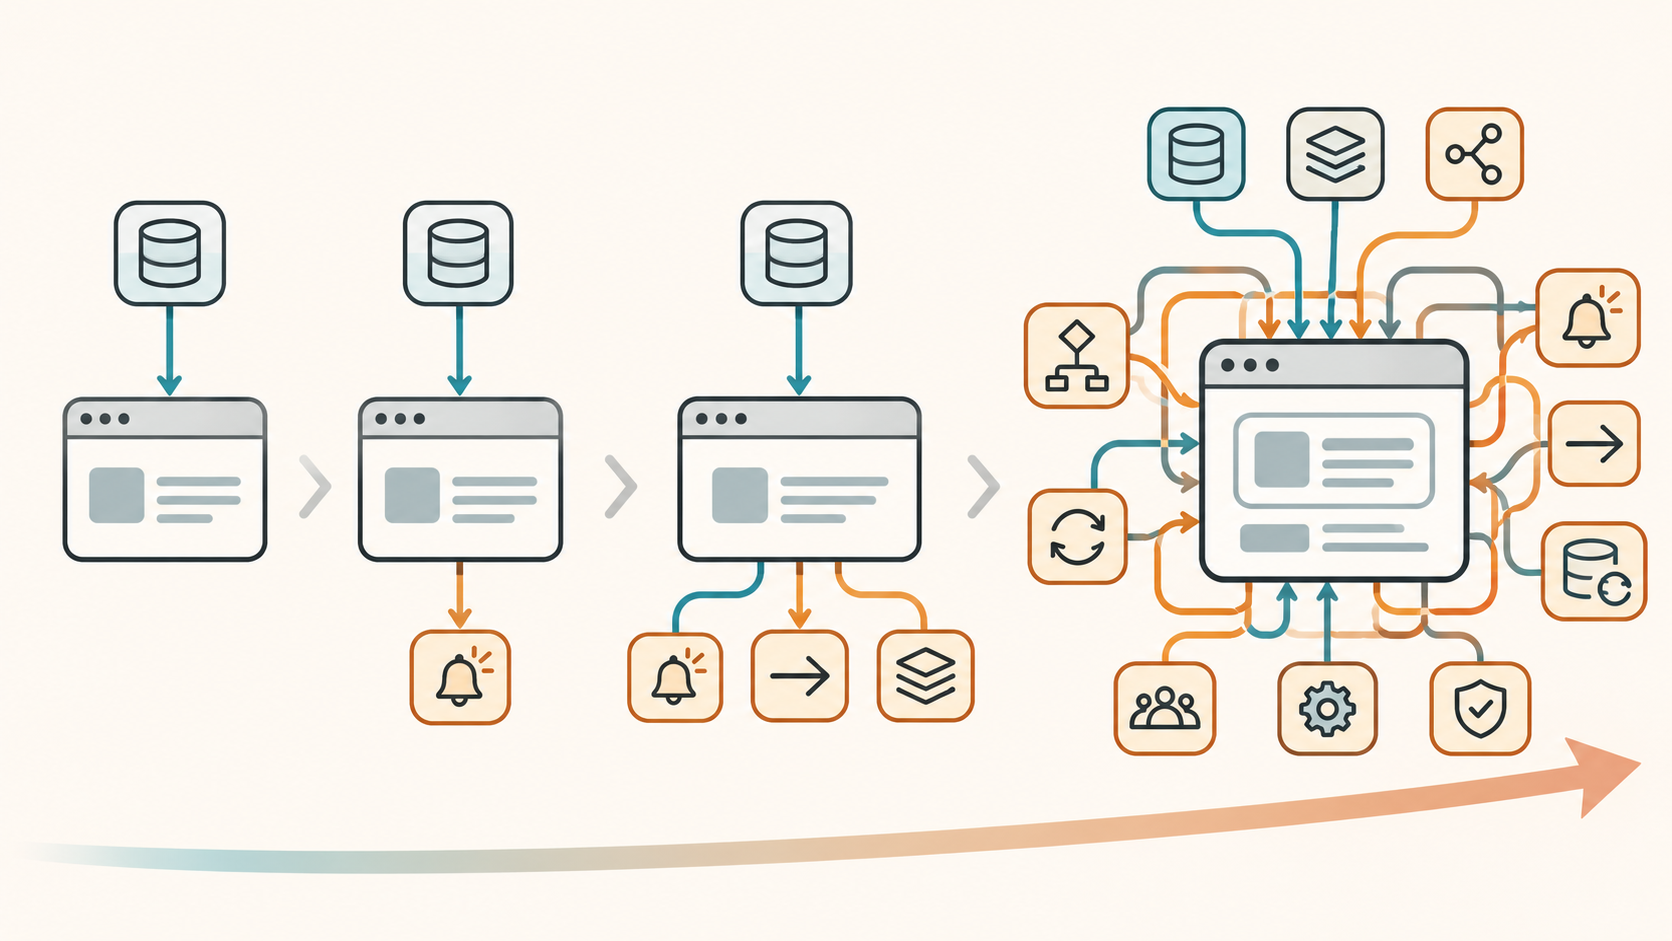
我的猜想是,Coding Agent 不仅可能让我们更快地实现新功能,也可能让结构性错误更快地被复制。
如果这些错误逐渐削弱架构边界,那么下一次由 AI 完成的变更反而可能需要更多工作。这篇文章要探讨的,正是这种尚未得到直接验证的反馈机制。
实际错误可能更早就会出现
Section titled “实际错误可能更早就会出现”假设一个组件根据路由参数加载条目。用户迅速从 A 切换到 B,于是产生两个彼此独立的 HTTP 请求。B 先返回,界面显示正确的数据;随后较早发出的 A 才返回,又覆盖了 this.item。界面突然显示过期内容。
问题不在于 Angular 不允许命令式语法,而在于异步操作没有得到协调。使用 switchMap 时,切换到 B 会取消前一个内部订阅;如果直接订阅的是 HttpClient Observable,尚未完成的请求也会被中止。前提是变化的 ID 经过同一条数据流。两次独立调用 loadItem() 不会自动协调。客户端中止请求,也不会撤销服务器已经执行的操作。至于界面读取状态,可以根据具体场景选择 AsyncPipe、toSignal() 或边界清晰的 Read Model。
变更检测(Change Detection)也需要准确区分。在订阅中给普通属性赋值,本身不会通知 Angular 发生了变化。视图是否仍会刷新,取决于其他触发因素与变更检测策略。AsyncPipe 会调用 markForCheck();更新在模板中读取的 Signal 也会发出通知。这在 zoneless Angular 中同样重要。对于派生状态,Angular 建议使用 computed(),并警告不要把 effect() 仅用于状态传播。
命令式语句本身并没有错。风险在于不断用局部同步规则替代清晰的响应式模型,却假定不会因此增加长期负担。
例外逐渐成为范例
Section titled “例外逐渐成为范例”一个变通方案很少会孤立地留在代码库里。其他人会读到它、复制它、再往上增加新的功能。新同事以它为参考,Coding Agent 也可能如此。昨天还有充分理由采用的特例,明天就成了所谓“项目里一直这样写”。如果架构边界不明确,仓库会对同一个设计问题给出相互矛盾的答案。
这让人联想到 Broken Windows(破窗效应)。如果只停留在比喻,它的说服力有限。但软件工程领域已经有实验研究:Levén、Broman、Besker 和 Torkar 在 2024 年分析了既有技术债对人类开发者行为的影响。实验包含 29 名参与者提交的 51 份解决方案。在技术债更重的 Java 系统中,研究者观察到更多重复代码、更差的命名以及更多静态分析问题。
这支持了特定实验条件下的破窗机制。但它既不能证明所有系统都会不可避免地走向失控,也不能证明 Coding Agent 会把这个效应放大。后两者仍然是开放问题。
Agent 不会自动继承我们真正想要的架构
Section titled “Agent 不会自动继承我们真正想要的架构”在我的实际工作中,即使是能力很强的 Coding Agent,也会偶尔回到熟悉的实现方式:把业务逻辑写进组件、用命令式流程同步状态,或者让一个 Capability 直接引用另一个 Capability 的内部实现。即使存在架构文档、Agent Skills,甚至可以使用 Angular 的工具,这种情况也会发生。
但不能仅凭这一观察就断言模型为何做出某次具体决策。训练中学到的模式、现有仓库的代码、任务描述、工具以及验收标准会共同发挥作用。把模型理解为“对训练样本里最常见的写法投票”,显然过于简单。
有一个范围更窄的命题已经得到实证研究。Yu 等人在 2026 年的 SWE-Shield 预印本中,检查了六个代码库的 495 个 Issue 与 1,787 条经过验证的设计约束。在功能上成功解决的 Issue 中,满足全部被检查设计约束的比例不足一半。额外提供设计指导可以减少违规,但无法将其完全消除。设计合规性主要由 LLM 验证器评估,并抽样与人工判断比较。这并不是完整的架构审查。
换句话说,功能正确不等于架构可接受。这个差距有实证支持。至于 Agent 是否会特别倾向于复制 Angular 项目里的坏模式,目前仍是我的观察,而不是研究结论。
Big Ball of Mud 的核心是边界失效
Section titled “Big Ball of Mud 的核心是边界失效”在我看来,Big Ball of Mud 不是“代码很多”,也不是“组件很长”。更根本的问题,是可靠的边界逐渐消失:所有权(Ownership)不清晰;业务规则散落在多个位置;模块可以随意访问彼此的内部实现。一个模块不再是可以局部理解的工作空间,而成了一个难以预测的依赖网络中的节点。
Foote 和 Yoder 在上世纪 90 年代就描述过这种系统如何由一系列局部合理、短期有利的决定逐步形成。这并不意味着系统很快就会停止工作。恰恰相反,它可能多年都能正常运行。
Bochicchio、Sas、Gilardi 和 Arcelli Fontana(2025)的实证研究考察了架构异味(Architectural Smells)与共同变更(Co-change)之间的关系。研究发现,与两个文件均无架构异味的文件对相比,至少有一个文件存在架构异味的文件对,其共同变更频率的中位数更高。这提示某些结构问题可能伴随更广的变更影响,但不能据此证明普遍的因果关系,也不能断言所有系统都必然持续恶化。
尚未回答的问题:下一次 Agent 任务要付出多少代价?
Section titled “尚未回答的问题:下一次 Agent 任务要付出多少代价?”到这里为止,这似乎只是一个老生常谈的软件工程故事。新的变量是吞吐量。Coding Agent 可以在很短时间内修改大量代码。如果验证能力跟不上,它们就可能更快地复制局部特例。当然,它们也可能更快地清理技术债。方向并不必然。
我的经济假设针对的是“下一次变更”。如果所有权、契约和依赖方向清晰,一个 Agent 理想情况下只需要理解有限的工作空间。但在高度耦合的系统中,更多文件、隐式副作用和相互冲突的约定可能都与任务相关。Agent 需要寻找、理解或者排除这些可能性。
这可能意味着需要收集更多上下文、调用更多工具、扩大测试范围并经历更多修复循环,最终提高每次经过验证的变更成本。但不是每次任务都会如此,更强的模型也可能抵消其中一部分额外开销。
Bai 等人(2026)在预印本中研究了八个模型使用 OpenHands 处理 SWE-bench Verified 任务的情况。输入 Token 占据了相当一部分成本,同一任务不同运行的 Token 消耗可能相差很大,而消耗更多 Token 并不自动意味着成功率更高。不过,这项研究并未检验不良架构是否导致这种消耗。我的因果链最后一环仍是假设。
哪些环节已经被研究,哪些还没有?
Section titled “哪些环节已经被研究,哪些还没有?”-
未协调的异步请求可能用旧结果覆盖 UI 状态。技术上可复现;Angular 与 RxJS 提供相应机制。
-
既有技术债可能促使开发者引入更多技术债。特定 Java 实验中对人类开发者得到支持(Levén 等,2024)。
-
Coding Agent 可能生成功能正确、却违反设计约束的补丁。已有实证研究(Yu 等,2026)。
-
架构异味可能与更高的共同变更频率相关。已有统计关联,但不是普遍因果证明(Bochicchio 等,2025)。
-
Agent 的 Token 消耗波动很大,输入 Token 占重要部分。已有实证研究(Bai 等,2026)。
-
更高的 AI 吞吐量可能加速架构侵蚀,进而可能提高长期 Token 与验证成本。完整的因果关系仍是开放假设。
我的假设——明确标注为假设
Section titled “我的假设——明确标注为假设”在架构边界薄弱的系统中,Coding Agent 生成变更的速度越快,某些结构性错误就可能传播得越快。如果这些错误扩大了下一次变更必须分析和验证的范围,那么后续 Agent 任务的成本也可能上升。
这将形成一种反馈:更快的代码生产改变了系统结构,而系统结构又反过来影响下一轮代码生产需要付出的努力。
不能把几项局部研究相加,就宣称整条因果链已被证明。相反的假设同样值得认真对待:更强的 Agent 也许能以更低成本理解 Big Ball of Mud、发现坏味道,并比产生新问题更快地完成重构。目前我们不知道哪种力量会在什么条件下占上风。
为什么我会拿 25 欧元订阅开玩笑
Section titled “为什么我会拿 25 欧元订阅开玩笑”一次关于 Guardrails 的讨论中,对方认为足够强大的 AI 完全可以自己做这些决定。就在前面,他还抱怨过订阅的使用额度很快耗尽。我半开玩笑地回了一句:“所以我的 25 欧元订阅够用,你的却不够。”
这只是一句带点锋芒的玩笑,绝不是 Benchmark。不同的模型、额度、任务和计费规则,使这种比较在方法上毫无意义。我自己也经常并行运行两到三个 Agent 任务,但日常额度通常够用。
我刻意采取的做法是:按 Capability 划分任务,不为每一个 Feature 重新商定架构,通过自动化检查而不是寄希望于实现者来维护边界。我还没有严格测量过这些做法是否节省 Token。真正值得衡量的,也不是第一次运行花了多少,而是每次经过验证、符合要求的变更总共要付出多少成本——包括增加许多后续 Feature 之后的成本。
Guardrails:少一些口号,多一些可验证的边界
Section titled “Guardrails:少一些口号,多一些可验证的边界”解决办法当然不是无限扩展 Agent 指令文件。Gloaguen 等人(2026)在预印本研究的设置中,没有发现代码库上下文文件能普遍提高任务成功率;推理成本平均增加了超过 20%。额外的要求即使被 Agent 遵守,也可能带来额外工作。
能通过系统自动验证的规则,我不愿意只依赖文字描述。禁止的 Cross-Capability Import 应当由架构检查拦截;业务不变量应该有测试;Capability 边界的理由则应该放在简短、可发现的文档和少量高质量范例中。自动检查过于粗糙的地方,仍需要有针对性的架构审查。
Guardrails 不应该规定每一个局部实现细节。它们应该让代价高昂的结构性决定保持稳定,直到我们有意识地改变它们。
怎样检验这个假设?
Section titled “怎样检验这个假设?”拿一个拥有完整 CI 的理想模块化系统,去对比一个缺少测试、长期无人维护的仓库,不会得到多少有价值的结论。变量太多。
更好的起点是功能相同、但架构边界经过受控调整的系统。让同一种 Agent 在多次独立运行中完成相同的一系列任务,例如连续 15 个 Feature。一组使用机械化边界检查,一组只有文档约束,第三组允许更多结构性自由。尽可能保持模型、工具、测试与验收条件一致。
我们需要记录设计约束违规、变更半径、Co-change、分析与验证步骤、修复循环、Token 消耗以及每次最终被接受变更的总成本。最重要的是看这些指标如何随任务序列演变,而不是只看第一个任务。
即使出现差异,那也首先是证据线索,而非完整因果证明。我们还需要重复实验、控制干扰因素,并清楚定义如何测量架构质量。
结语:不应该只衡量第一次变更
Section titled “结语:不应该只衡量第一次变更”AI 能生成更多代码,不等于好的架构就失去价值。它反而可能意味着,我们更需要关注架构边界是如何被侵蚀的。
我并不认为 Coding Agent 注定会制造更差的架构。它们同样可以发现并修复结构性问题。但是,只要功能正确还不能可靠地代替设计合规,而架构与 Agent 成本之间的直接联系又尚未厘清,我就看不出为什么要急于放弃有价值的边界。
真正值得问的,不只是“Agent 今天能多快做完一个 Feature?”
而是:“今天的实现会如何影响接下来一百次变更的成本?”
因为在 AI 的帮助下,我们加速的可能不只有交付。如果不维护架构,也可能是在加速走向 Big Ball of Mud。
研究资料与延伸阅读
Section titled “研究资料与延伸阅读”- William Levén, Hampus Broman, Terese Besker, Richard Torkar (2024). The broken windows theory applies to technical debt. Empirical Software Engineering 29, 73.
- Kai Yu et al. (2026). Does Pass Rate Tell the Whole Story? Evaluating Design Constraint Compliance in LLM-based Issue Resolution. SWE-Shield; 预印本, arXiv:2604.05955v1.
- Matteo Bochicchio, Darius Sas, Alessandro Gilardi, Francesca Arcelli Fontana (2025). An empirical study on architectural smells through a pipeline for continuous technical debt assessment. Information and Software Technology 185, 107783.
- Thibaud Gloaguen et al. (2026). Evaluating AGENTS.md: Are Repository-Level Context Files Helpful for Coding Agents?. 预印本, arXiv:2602.11988v3.
- Longju Bai et al. (2026). How Do AI Agents Spend Your Money? Analyzing and Predicting Token Consumption in Agentic Coding Tasks. 预印本, arXiv:2604.22750v3.
- Brian Foote, Joseph Yoder (1997/1999). Big Ball of Mud. PLoP ’97, WUCS-97-34; Web 1999; Pattern Languages of Program Design 4, 2000.
- Angular: HTTP Observables / cancellation, Zoneless, Signals / computed, Effects, RxJS interop.
- RxJS: switchMap.